“华为AI战略的核心是算力。”9月17日,华为副董事长、轮值董事长汪涛在上海举行的华为全联接大会2026上表示,华为将聚焦AI基础设施,坚持硬件变现,围绕“超节点+集群”推进系统架构创新,同时构建开源开放的算力生态。
围绕这一方向,汪涛现场介绍了昇腾960系列芯片,披露其研发进度,同时发布可容纳4096张计算卡的昇腾960超节点。
其中,昇腾960DT计划于2027年第一季度就绪,比原计划提前三个季度;960PR计划于2027年第三季度就绪,比原计划提前一个季度。此后,昇腾系列芯片将保持一年一代的演进节奏,计划于2028年、2029年陆续推出昇腾970、980,继续提升算力规格。
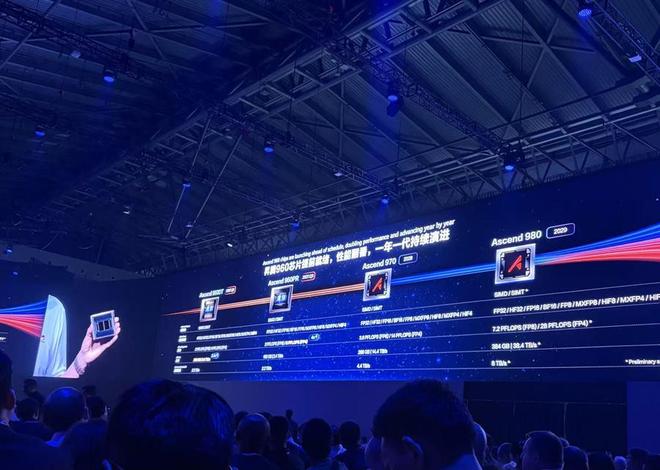
汪涛现场介绍了昇腾960系列芯片,披露其研发进度。
与芯片升级相配合,昇腾960超节点着重解决大量芯片如何高效协同的问题。据介绍,单个超节点最大可提供8E FP8(即在8位浮点精度下,每秒可进行800亿亿次浮点运算)的算力,配备最高1PB的高带宽内存,其液冷版本计划于2027年第三季度上市。汪涛同时披露,昇腾910C超节点已部署超过1000套,昇腾950超节点已规模商用。
超节点的重要性,与AI任务规模和复杂程度的变化有关。汪涛指出,智能体已经可以按小时级连续工作,到2030年预计将以月为单位执行任务;中国推理Token(词元)已增长到每日500万亿左右,到2030年预计将达到百万万亿级。模型从回答问题走向持续处理复杂工作,对计算系统的规模、效率和可靠性提出了更高要求。
但计算系统的规模扩大,也会带来更多通信开销。在华为分析的十万卡训练场景中,传统服务器架构下的芯片间通信耗时超过训练时间的40%,制约了MFU(模型浮点算力利用率)。该指标反映的是理论算力有多少真正用于模型计算。
超节点通过高速互联和统一的内存编址,让分散在不同设备里的计算、内存资源,在逻辑上像一台计算机一样协同工作。华为马尔科夫实验室的仿真结果显示,采用4K超节点组成的十万卡集群,相比由8卡服务器组成的同等规模集群,MFU提升了2.75倍。
本次会上还发布了光互联产品Hi-ONE。作为提高数据传输效率的关键部件,它采用近封装光学技术NPO,让光学器件更靠近计算芯片,使高速电信号尽早转换成光信号,以适应大规模数据传输。
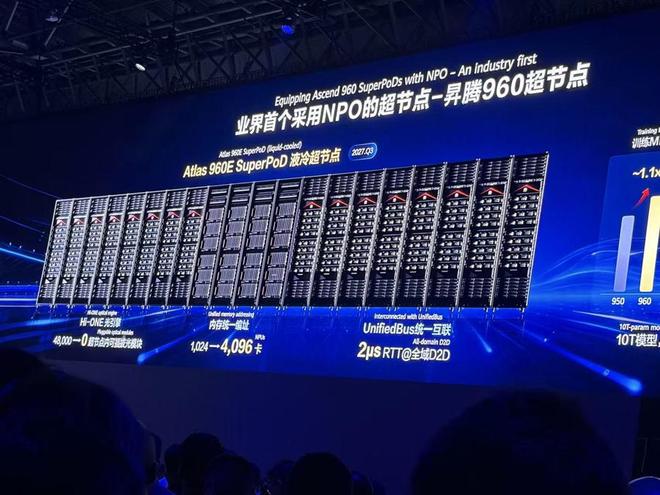
华为表示,昇腾960超节点是业界首个采用NPO技术的超节点。
华为表示,昇腾960超节点是业界首个采用NPO技术的超节点。按照其公布的方案,5500个Hi-ONE可替代原方案所需的4.8万个800G光模块,降低超过550千瓦的功耗。
除了昇腾超节点,华为还发布了升级的鲲鹏超节点和 M900 AI记忆存储系统,分别支持通用计算和AI推理中的缓存需求。
按照其组网方案,昇腾超节点、鲲鹏超节点及缓存系统等通过灵衢互联协议连接,最大可支持百万张昇腾卡组成的集群,将计算、互联和存储能力协同用于大模型训练与推理。
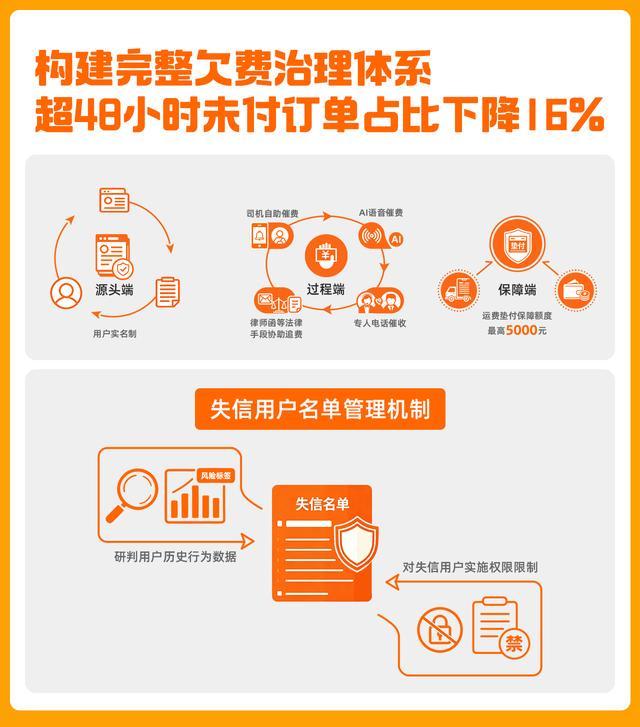
货拉拉第八次公开算法,涉运费拖欠治理、打击假单及不实投诉
货拉拉公开平台算法规则,规范用户不诚信行为,涉及运费拖欠、虚...(53 )人阅读时间:2026-09-18
“华为AI战略的核心是算力”,昇腾960超节点亮相
华为AI战略核心为算力,聚焦AI基础设施,坚持硬件变现。华为...(130 )人阅读时间:2026-09-18
因190条违法广告,拼多多又“栽跟头”
拼多多因发布190条违法广告被罚54万元,这是继“幽灵外卖”...(175 )人阅读时间:2026-09-18
开源模型夯爆了!ZDTaichu5.0-9B,10B以内空间
MindCube-tiny 榜单测试模型构建三维心智地图的能...(123 )人阅读时间:2026-09-18 美国网络安全初创公司Frontier Security发现A...
 昆仑万维CEO方汉宣称SkyProduction天工工作台4...
 WorkBuddy最新更新了远程控制功能,因国内直连体验优于...
 DeepSeek V4.1 Flash模型正式发布,为全新最...