作者 许丽思
编辑 漠影
智东西9月23日报道,近日,物理AI公司息壤开物(XIRRA)已在两个月内连续完成数亿元种子轮及天使轮融资,由敦鸿资产领投,华控基金、三花控股、银杏谷资本、泽然资本、本坚基金、上海天使会、标朴投资等知名机构跟投。
这家公司由两位华为大模型核心人物联手创办:创始人、CEO李寅曾任华为云大模型CTO,拥有万卡级模型训练及丰富的产业落地经验;联合创始人、首席科学家张含望是南洋理工大学教授,长期从事因果机器学习与多模态智能研究。
两人选择了一条技术门槛极高的路线:从底层研发原生物理基础模型(Large Model,LPM),希望通过一套通用底座,将物理智能能力推广机器人、自动驾驶等不同产业场景,乃至科学计算领域。
这一技术路线已取得阶段性成果。在9月16日公布的 2.0全球总决赛榜单中,息壤开物在Track 1视频质量赛道取得轨迹精度全球第一、物理合规性全球前三的成绩。
为什么一家初创公司,要从底层重新研发一套物理基础模型?
回看数字AI的发展,在GPT等大语言模型出现之前,自然语言处理(NLP)领域高度依赖单场景定制,不同客户、不同任务,往往需要单独开发模型。直到大语言模型出现,越来越多的企业开始基于统一底座开发应用,推动AI1.0时代到来。
如今,AI正加速走向真实物理世界,具身智能融资与产品演示持续升温,规模化商业落地却仍面临挑战。
机器人换一种物料、换一个工位,往往又要重新采集数据、训练模型和工程适配。高昂的定制化成本,让机器人能力难以快速复制到更多场景。
AI 2.0时代,能否也出现一套通用基础模型,让机器人具备跨任务、跨本体、跨场景的泛化能力,让更多行业客户低成本开发自己的具身大脑?
这正是息壤开物希望探索的问题。该公司本轮募集资金将主要用于原生物理AI模型的规模预训练、真实物理交互数据建设、核心研发人才引入及场景验证。
一、华为大模型双子星联手,工程基础与理论研究强强结合
对于一家初创公司而言,从底层开展原生预训练意味着持续的研发投入,也需要团队具备从基础模型设计、大规模训练到实际应用的完整经验。
正是在这样的技术判断下,李寅与张含望选择联手创业,将各自在基础模型领域的积累投入物理智能研发。
其中,李寅毕业于清华大学,曾任华为云大模型CTO、华为云大模型0到1核心成员,长期统筹基础模型、多模态、视频生成、科学计算与行业大模型研发。
她曾带400人团队、用1.5万小时数据,在1.5万卡集群上2个月完成8B视频大模型训练发布;主导过国内多地具身智能创新中心、头部车企自动驾驶数据生成等行业AI解决方案,相关项目每年带来数亿元营收。
张含望是南洋理工大学计算与数据科学学院 Chair ,长期聚焦因果机器学习与多模态智能,累计发表论文228篇, 引用超4.2万、H-index 81,2026年 “”方向全球排名第8,曾获新加坡总统科技奖青年科学家奖、IEEE AI’s 10-to-Watch等荣誉。
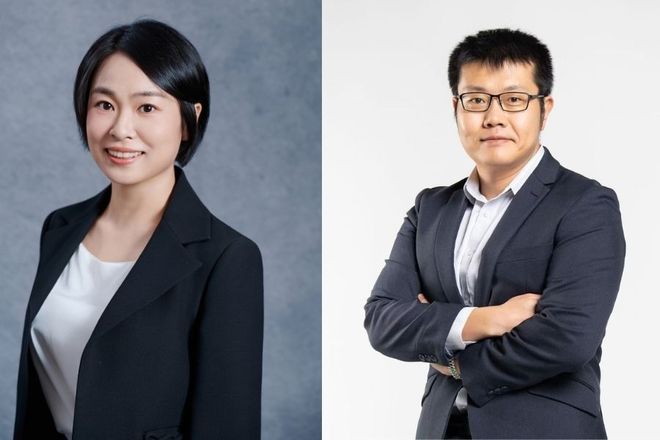
两位创始人的经历,也让息壤开物形成了理论研究与工程实践相结合的硬核配置。
据了解,该公司核心成员也都来自华为大模型体系,拥有万卡级训练、视频大模型、多模态研发及复杂行业交付经验。
对于准备从底层开展物理基础模型研发的息壤开物而言,这些积累成为其探索原生物理预训练、搭建配套工具链,并推动模型走向产业应用的重要基础。
二、不走增训路线,押注原生物理基础模型
目前,主流具身模型多采用“VLM+ Head”的增训路线,拿现成视觉语言模型当底座,补动作数据,接动作输出头。
这种方式能够利用已有的大模型能力,开发成本低,帮助团队较快完成特定任务开发,不少本体厂商借此快速拉升估值。
但是,视觉语言模型主要从数字世界中的视觉和语言数据学习知识,对物理世界规律的抽象归纳存在局限,在物理规律理解、长程决策及跨场景泛化方面仍面临挑战。
息壤开物因此选择从底层构建物理基础模型LPM,通过原生物理预训练,让模型学习物理规律及状态、动作之间的关系。
物理基模有望解决机器人的泛化难题,不过真正从底层研发的团队非常有限,因为这件事情难度实在太大了。
以常见的机器人在工厂抓取、搬运工件这件任务为例,看似简单的操作,背后却涉及物理基础模型必须跨越的四道技术门槛:
物理世界连续、高维、不可完全观测:机器人需要判断工件的位置、重量和接触状态,连续处理变化的运动、接触、形变及力觉信息,实时调整抓取力度,状态空间比文本大出几个数量级。
长程决策的组合爆炸:从抓取、搬运到放置,每一步都有多种动作选择,前一步的偏差还会影响后续操作,动作组合迅速膨胀。
数据稀缺且异构:真实操作数据采集成本高,视频、运动轨迹、力觉和触觉等数据格式各异,难以直接用于统一训练。
仿真与现实存在差距:仿真中能够成功抓取的机器人,进入真实产线后,可能因摩擦力、接触状态等变化而失败,需要根据真实反馈持续调整。
所以,息壤开物选择回到第一性原理,以贝尔曼方程的最优性原理作为模型的理论基础。
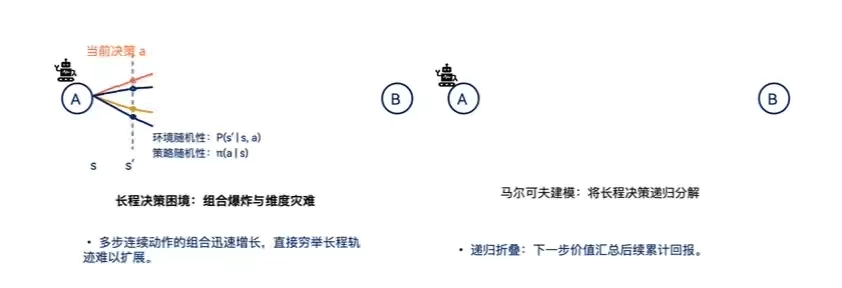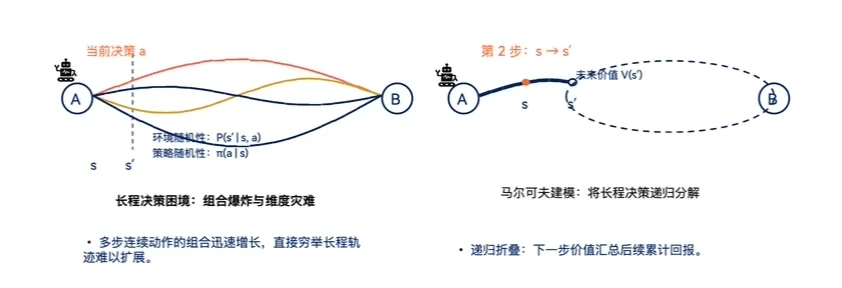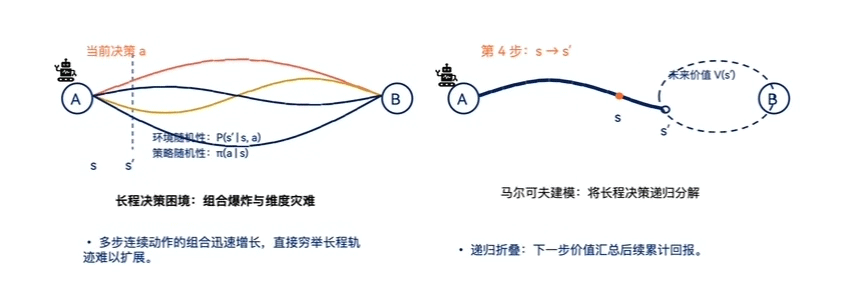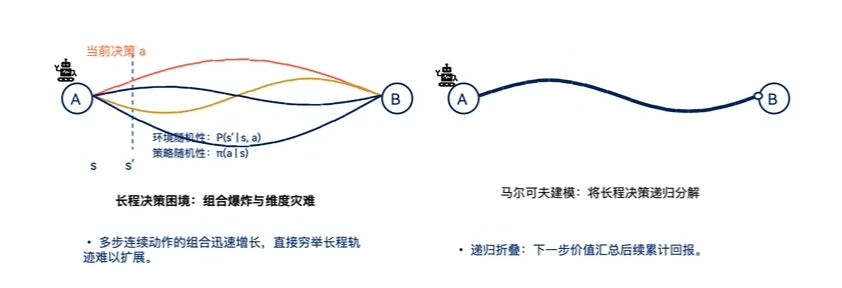
LPM = 贝尔曼递推方程的最优解:让模型逼近长期累计回报最优的决策
具体来说,贝尔曼方程把长程决策递归分解,让模型同时学习世界转移P、价值V与策略π——世界模型与策略模型(类似 VLA)的能力,在同一个基础模型里被统一。架构上,LPM将世界推演与视频渲染解耦:AR自回归架构负责组织因果历史、推演”发生什么”, 负责渲染”看起来什么样”。
息壤开物从物理交互数据的统一编码、状态—动作—结果建模和长程一致性学习切入,让模型在预训练阶段就习得物理世界的规律,能力才有机会随规模持续涌现。
三、授人以鱼不如授人以渔,让行业客户在基座上长出自己的模型
目前,具身智能的许多项目仍高度依赖单场景定制,企业需要针对客户需求采集数据、训练模型、调试设备,再完成现场交付。换一个客户、增加一项任务,类似的流程可能又要重新来过,已有模型能力难以充分复用。
息壤开物选择了一条“授人以渔”的平台化路线:让制造企业、本体厂商和场景方能够基于通用物理基础模型及配套工具,通过行业增训和应用适配,开发适用于自身场景的具身智能模型。
围绕物理基础模型LPM,息壤开物已经构建XR数据平台和XR评测平台,并提出通过配套开发工具支持行业模型增训与适配,逐步形成从数据处理、模型训练到能力验证的开发工具体系。
机器人执行任务时产生的真机轨迹、人类示教视频,以及不同传感器记录的物理信息,格式和质量要求各不相同,缺乏统一标准,很难被高效地用到模型训练上。
息壤开物的XR数据平台,覆盖多模态数据接入、清洗、标注、质量检查、版本管理与发布的完整流程,并通过标准化具身大脑 API 对外提供能力调用。
同时,其还保持跨本体、跨模型的中立定位,把真机轨迹、人类示教、真实失败案例等物理世界经验,编译成可训练、可追溯、可迭代的高质量数据资产,提升不同来源数据的可用性和复用效率。
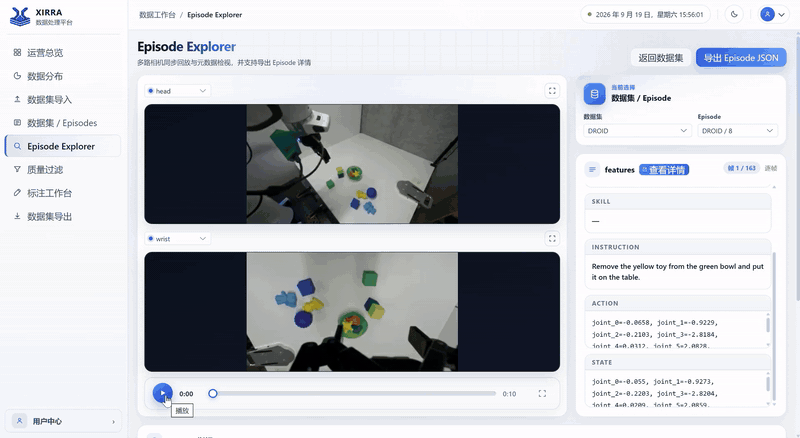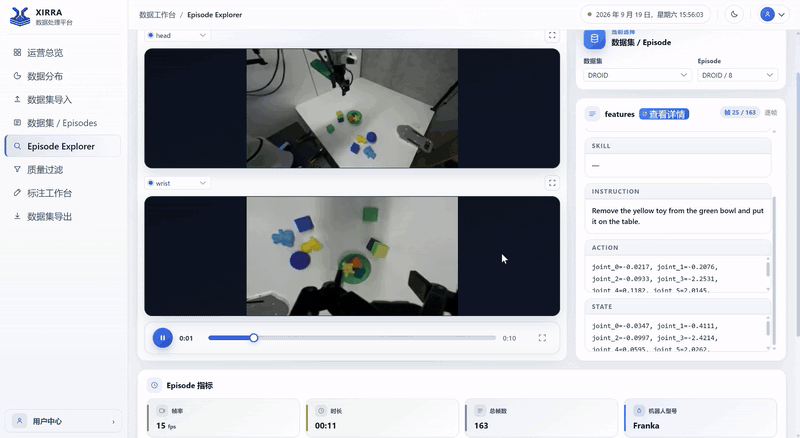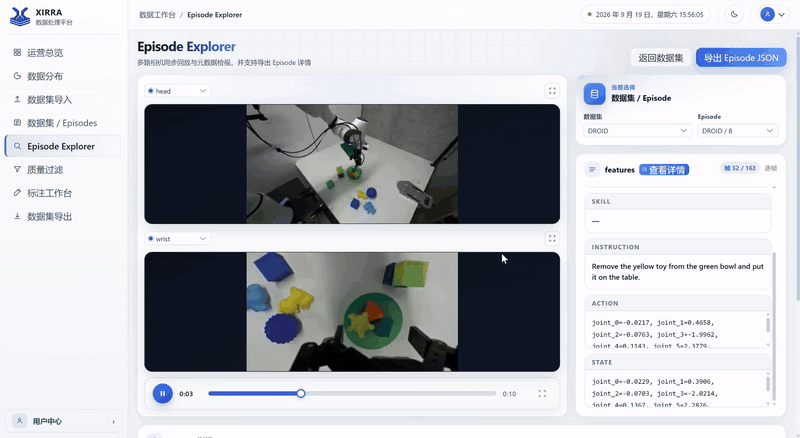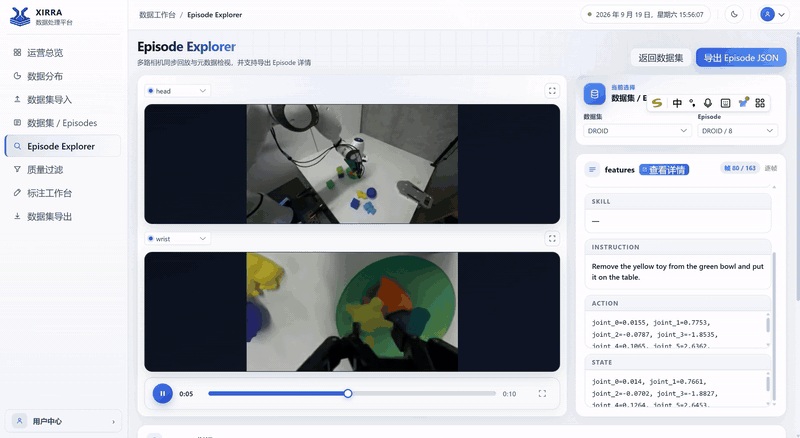
数据平台demo——数据展示
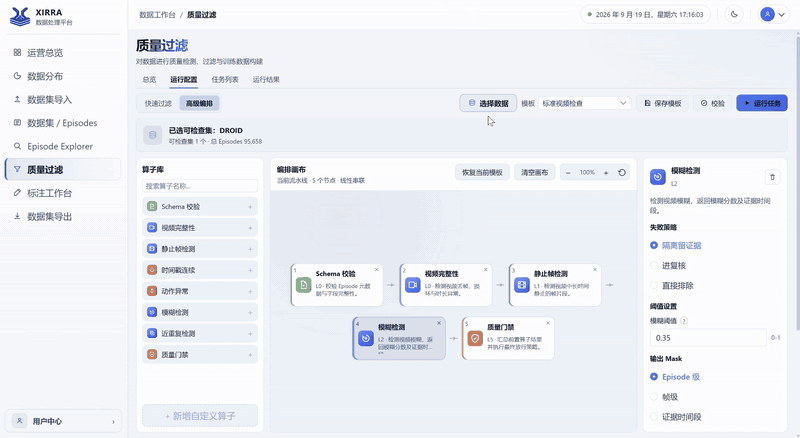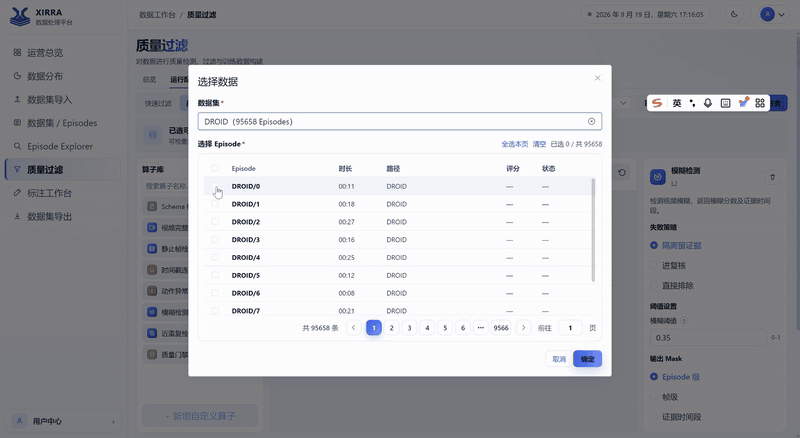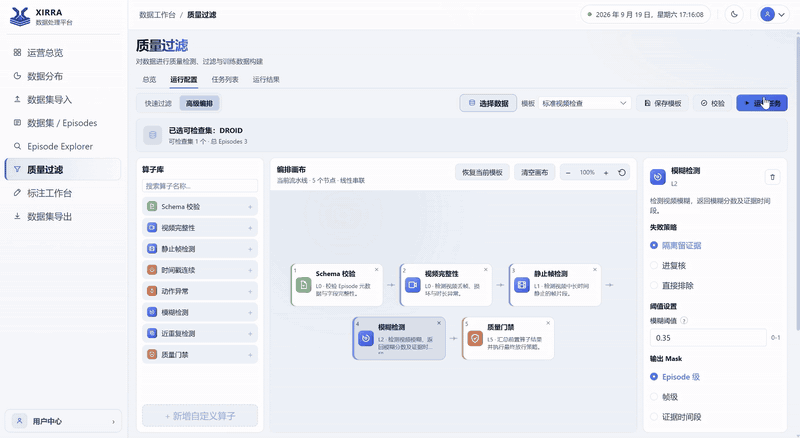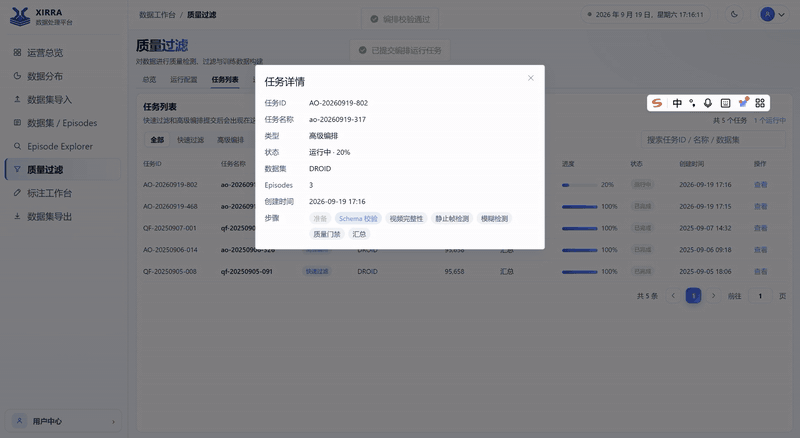
数据平台demo——数据过滤管线
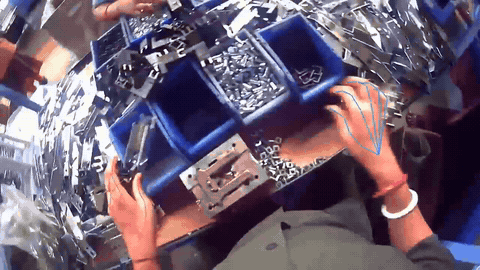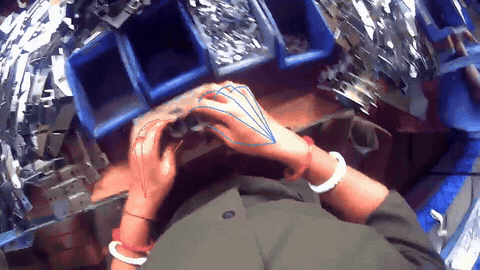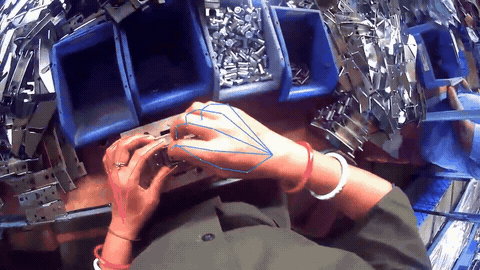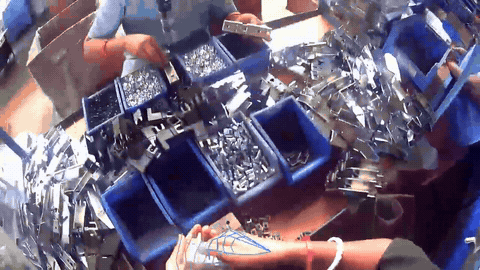
数据平台demo——EGO数据管线
XR评测平台
数据进入模型训练流程后,接下来要判断模型究竟学到了什么。当前具身智能模型能力快速迭代,不同评测环境、机器人本体和任务设置下的成绩却很难直接比较,仿真表现也难以完整反映真实场景中的作业能力。
息壤开物的XR评测平台已实现从场景构建、质量检查、策略执行到报告生成的完整工作流程,支持评测场景复用,以及执行过程、评测报告的保存回查。
平台打通仿真场景构建、模型推理与结果可视化全链路,把过去高度依赖人工的工作链路打造为自动化闭环;失败样本可在此完成定位、补数与复验,持续回流至下一轮模型训练,形成评测即飞轮、越评越强的迭代效应。
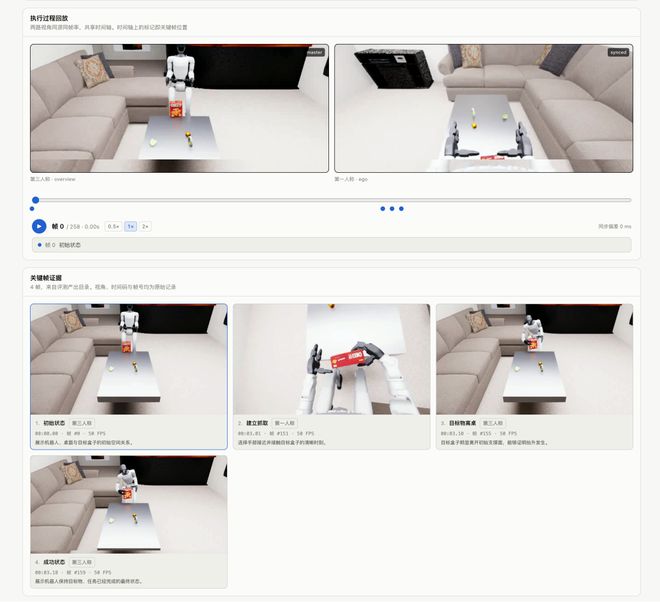
评测平台——理解、生成、执行三位一体,让每次失败都产生可用的训练信号
这套体系能力已经得到第三方验证。是由清华大学等高校研究团队推动的国际具身世界模型评测基准,聚焦于评估模型的感知质量及其在实际具身任务中的功能价值。
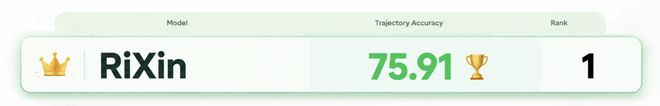
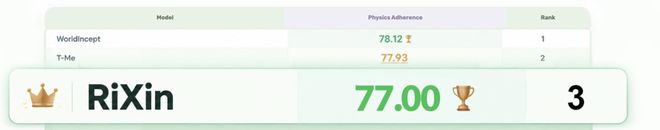
9月16日, 2.0全球总决赛榜单公布,息壤开物在视频质量赛道拿下 (轨迹精度)全球第一、 (物理合规性)全球TOP3——前者考察给定动作策略后模型对运动轨迹的精确还原,后者直接衡量模型对物理规律的遵从,两项都是最能体现物理建模能力的指标。
四、200+项目、万卡工程经验打底,一套底座如何通向所有物理场景?
基础模型与平台工具逐渐成形后,息壤开物还需要解决商业化落地问题:一套通用底座,究竟应该怎样进入不同行业?
回看数字AI的发展,通用大语言模型的出现,让企业能够基于统一底座开发不同应用,减少面向每个客户重新研发专用模型的投入。息壤开物希望将这一思路延伸至物理世界,通过复用通用物理能力,改善具身智能高度依赖单项目定制的成本结构。
围绕这一目标,息壤开物提出L0、L1、L2三层商业化架构:
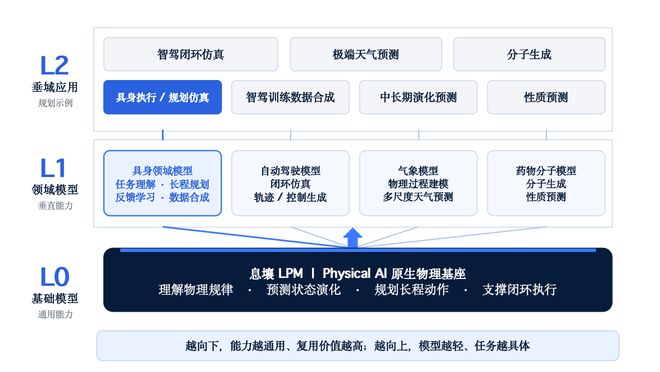
L0物理基础模型(LPM):提供理解物理规律、预测状态演化、规划长程动作、支撑闭环执行的通用物理能力。
L1领域模型:在L0之上加入行业专业数据增训,形成具身操作、自动驾驶、气象、药物分子等领域模型。任务理解、长程规划、闭环仿真、多尺度物理过程建模等行业级能力,都在这一层长成;
L2垂域应用:蒸馏出面向具体场景的轻量应用,完成最终交付。从产线上的具身执行与规划仿真,到智驾的闭环仿真与训练数据合成,再到极端天气预测、分子性质预测,任务越具体,模型越轻。
这套架构的商业价值,落在不同层级之间的能力复用上。对于机器人本体厂商或制造企业而言,可以基于L0获得通用物理智能能力,再结合自身行业数据形成L1领域模型,根据具体生产任务开发L2应用,逐步降低重复研发和部署成本。
更重要的是,李寅此前积累的产业经验,为息壤开物探索这条商业化路径提供了实践基础。
李寅曾参与华为云大模型从研发到产业应用的全过程,其过往团队累计交付200多个行业AI项目,覆盖金融、制造、能源、政务等30多个行业,相关项目累计金额超过10亿元,深谙如何从客户场景拿数据、做模型、交付结果,再把失败样本回流到下一轮训练。
同时,她还具备万卡集群稳定训练、万亿参数常稳训练与极致推理优化的完整工程积累,集群可用度99.7%,拥有昇腾首个万卡超节点集群调测实战经验。
这些大规模模型训练与产业交付经验,也为息壤开物将通用物理基模的研发、训练和场景验证串联起来,推动模型能力从单点任务向跨场景复用延伸,提供了重要的工程基础。
在具体落地路径上,息壤开物计划优先在机器人领域建立商业化闭环:面向本体厂商,通过标准化API、SDK及模型授权输出具身大脑能力;面向工业和物流客户,则围绕工业分拣、仓储拆码垛、柔性装配等任务,探索行业模型增训与联合交付,并在实际应用中持续沉淀数据和开发工具。
机器人场景只是息壤开物规划中的第一步。其物理基础模型希望学习的,是能够跨领域复用的物理规律理解与状态演化预测能力。
沿着这一思路,该公司计划将同一套底座延伸至自动驾驶的闭环仿真、极端天气预测和中长期演化推演,以及药物分子的生成与性质预测等领域,通过行业数据增训与具体应用开发,探索通用物理智能能力在不同产业中的复用。
依托通用底座、标准化工具及既有产业交付经验,息壤开物希望逐步降低新增场景的模型研发和部署成本,实现物理基础模型的规模化商业落地。
结语:构建基模训练飞轮,打开物理智能长期增长空间
随着物理智能走向更多产业场景,基础模型和标准化开发工具的潜在需求正在拓展,带来不少新机遇。
息壤开物提到,国内多地正在建设具身智能创新中心与训练场,公共底座与工具链是其中的刚需;海外市场对高质量物理数据与评测能力同样饥渴,在完成合规与管制评估的前提下,标准品输出具备可观的想象空间。
更重要的是,这些商业化路径之间是相互咬合的:真实场景交付带来数据,数据反哺基础模型训练,模型能力提升又进一步降低后续交付成本。随着这一循环持续运转,商业化本身,也将成为推动基模持续进化的训练飞轮。
从真实物理世界中不断汲取数据与经验,让通用智能持续生长,再将积累的能力应用于更多产业场景,“生生息壤,开物造智”,息壤开物走的,就是这样一条难而正确的路。
刷视频也能教会机器人干活!1200亿tokens人类动作预训
Figure将Helix 2.5机器人带入30个陌生家庭,执...(156 )人阅读时间:2026-09-23
华为大模型双子星联手造物理基模,刚融资数亿元
物理AI公司息壤开物完成数亿元种子轮及天使轮融资,由华为大模...(110 )人阅读时间:2026-09-23
Meta刚登顶,千问就交卷!3亿人的个人AI助理要来了
Meta的AI助手Muse上线后迅速登顶App Store免...(68 )人阅读时间:2026-09-23
Fable 5.1超越人类却贵了2.5倍,NeoCognit
NeoCognition 的 ApprenticeBench...(123 )人阅读时间:2026-09-20 Fable 5.2版本曝光并开启灰测,实测显示其高推理模式下...
 FDE(前线部署工程师)在大模型兴起后需求激增,负责将AI接...
 美国FCC更新清单,将外国先进机器人及联网电力逆变器列入管制...
 微软正测试在Windows Performance Anal...