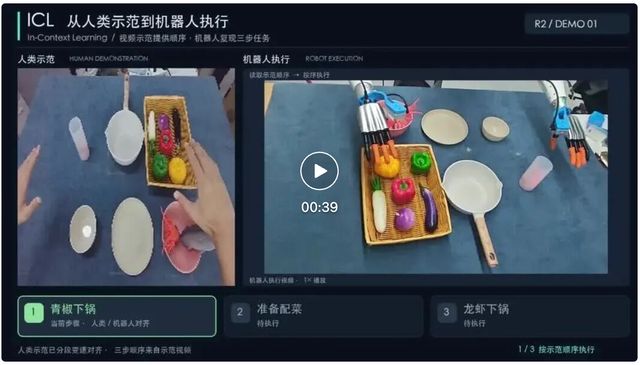
人类示范「准备配菜 — 青椒下锅 — 龙虾下锅」三步流程后,Psi-R2.5 通过 In- 按顺序复现任务,无需重新训练模型。
同样是炒菜,两年前关注的是机器人「会不会」,现在灵初更关注机器人「怎么学」。
对人来说,拿起锅铲,翻动食材,几乎都是下意识完成的。那能不能跳过一遍遍的采集真机数据,直接把人类的操作经验拿来训练机器人?
灵初此前已经在沿着这条路前进。
四月发布的 Psi-R2 和 Psi-W0 将十万小时规模的人类数据用于预训练,并通过 Psi-W0 和强化学习,把人手轨迹进一步优化成机器人能够执行的轨迹。但这意味着, 与 World Model 需要反复 ,轨迹还要继续用强化学习微调,整个转换链路依然繁琐。
现在,灵初智能正式发布新一代具身基础模型 Psi-R2.5。
这一次,团队没有继续把重点停留在「十万小时人类数据」上,而是开始处理数据规模起来之后的两个新问题:哪些数据真正有价值,以及怎样让这些人类数据更顺畅地进入机器人的训练过程。
在数据转换方面有一个关键变化,既然从人类数据到机器人数据的转换很麻烦,能不能反过来,先从本来就能执行的真实机器人数据出发?
答案落在了Pair Data上。
Pair Data:让人类数据真正进入机器人训练
为什么不能直接把人类视频拿来训练机器人?核心还是 Gap。
一方面,人手和机械手在视觉上存在差异,相机参数、环境变化等也会带来 Gap;另一方面,人类 与真实机器人数据之间还存在手部姿态估计、关节结构带来的运动学误差,以及摩擦力等物理参数误差,也就是 Gap。
前面提到,上一代 Psi-W0 已经能够将人手轨迹优化成可执行的机器人轨迹,但每条数据仍需要经过 World Model 和强化学习微调。
Psi-R2.5 改变了 Pair Data 的构建方式。
灵初把只按照相同任务语义收集的数据称为「弱 Pair Data」;如果图像上除本体外基本一致、时序上逐帧对应,同时 可以直接在机器人上 ,则称为「强 Pair Data」。
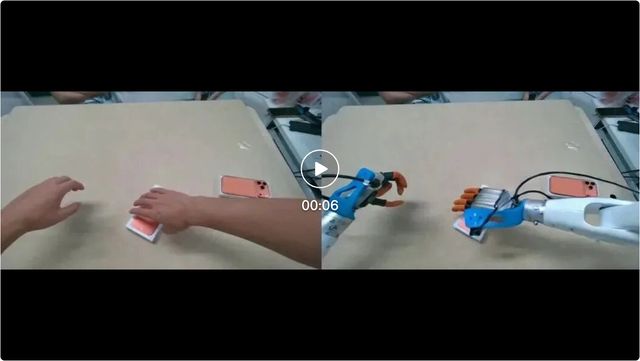
视频地址:
强 Pair Data
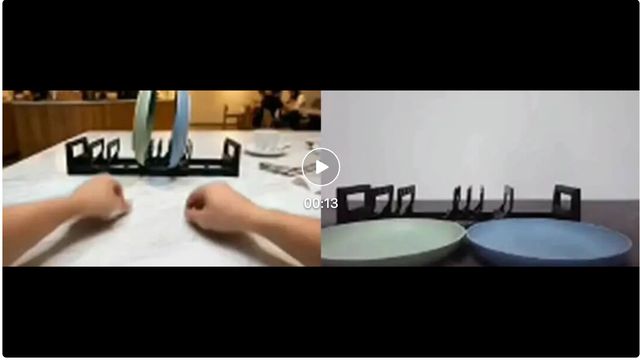
视频地址:
弱 Pair Data
团队从真实机器人数据出发,逆向生成对应的人手数据。
这一步很有意思:最终明明是要把人类数据转成机器人数据,为什么先反过来生成一遍人手数据?
关键在于,真实机器人数据本身已经包含可以直接使用的图像和 。团队从这些机器人数据出发,生成与之一一对应的人手数据,就先得到了一批成对的人类 — 机器人数据。
有了这批强 Pair Data,团队进一步训练了带 的端到端人类数据到机器人数据转换模型,让新的人类操作数据可以直接与机器人数据对齐。
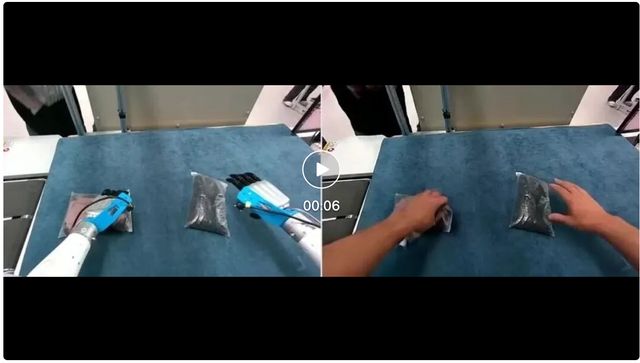
视频地址:
那要怎么验证转换有没有用?一是可以把转换后的机器人数据直接放到真机上 ;二是拿这些数据继续训练模型。
最终,人只需要用普通手机或相机拍下一段操作视频,就可以通过这套 将其转换成不同机器人的数据。
视频地址:
相比上一代,这一次真正缩短了「拿到一段人类数据」和「得到机器人真正能用的数据」之间的距离。
从人类示范到真实任务,只要 1—2 个工作日
但把人类数据转换成机器人能够使用的数据,只解决了「怎么学」的问题。
面对具体场景,机器人还需要处理任务步骤和现场环境等一系列的变化。
因此,Psi-R2.5 在模型结构上也做了调整。
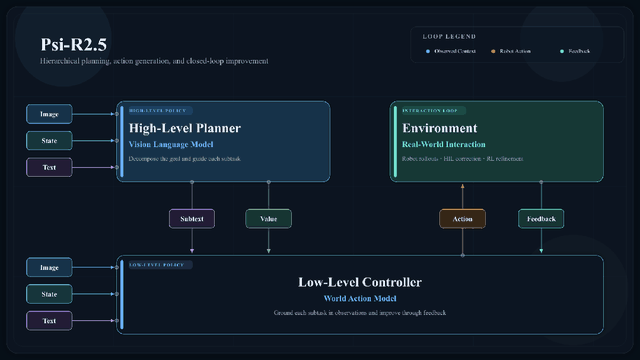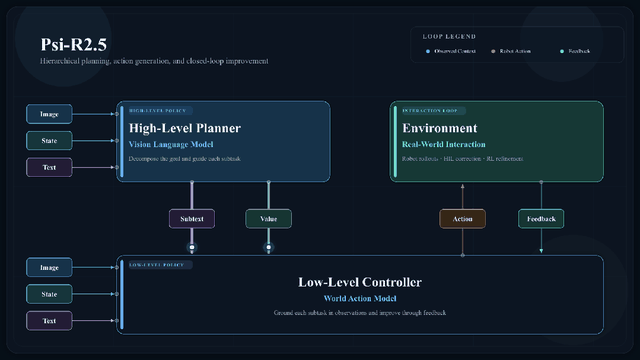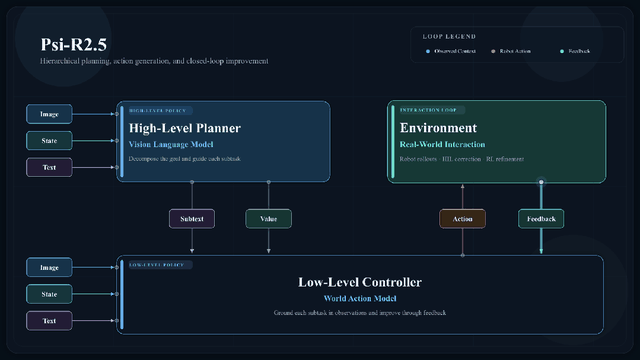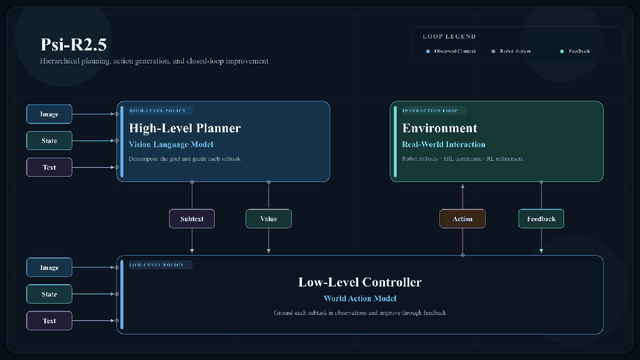
相比上一代 Psi-R2 和 Psi-W0 两个模型分别承担不同功能,R2.5 采用了双层架构:上层负责长程任务拆解,把一段长 分解成对应的 ;下层再结合当前观测,输出机器人具体的操作轨迹。其中,上层模型以 .5-4B 为骨干,下层则使用 Wan2.2-IT2V-5B,两者通过同一批预训练数据进行训练。
不过,基础模型到了真实客户现场,仍然很难做到不经过额外训练,就直接应对所有任务。不同场景里的 SKU、步骤和作业节拍往往高度定制,所以后训练在相当长一段时间内仍然是必要环节。
为此,灵初开发了一套基于灵巧手的 HIL(Human-in-the-Loop)+ RL 后训练框架:只需要少量数据,就可以在基础模型上继续微调;部署过程中出现的失败案例,也会实时回流,用于后续迭代。
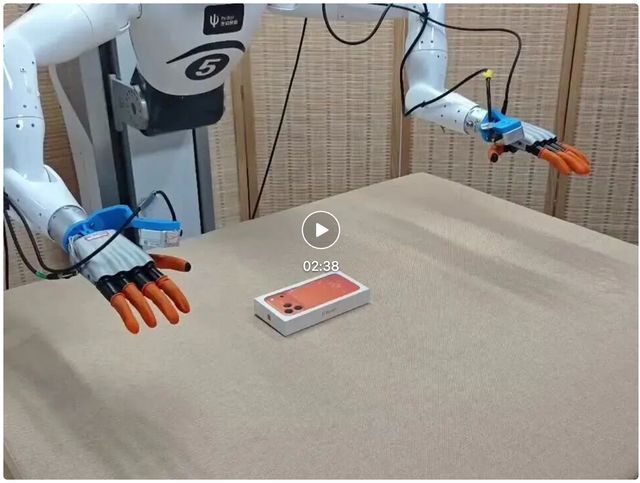
来看一个直观例子:手机盒装配。
这是一个步骤很多、同时对精细操作要求很高的任务。如果直接从零开始用模仿学习训练,成功率很低;而在 HIL 和后训练 RL 的基础上,经过几轮迭代后,成功率可以提升到 99%,整个过程只需要 1—2 个工作日。
视频地址:
Pair Data 解决了怎样让人类示范成为机器人真正能用的训练数据,而 HIL 和 RL 则是让模型在进入具体现场之后,能更稳定地完成任务。
对于临时出现的新任务,Psi-R2.5 还探索了另一种更轻量的方式:In- 。人先示范一遍,再把这段轨迹作为类似 的上下文输入,让机器人根据示范完成之前不会的任务。
机器人的 和语言模型还有一点不同,它不是单纯的一段文字,而可以是一段人类示教视频。
借助前面的强 Pair Data 转换能力,人类示范可以先被转换成对应的机器人数据,再作为 输入模型。ICL 可以让机器人在不更新模型参数的情况下,根据文本提示或物理提示,对新任务进行零样本泛化。
视频地址:
从实际使用上看,这两种方式可以对应不同的任务需求:需要长期稳定执行的任务,可以继续通过后训练和现场数据迭代;面对新的任务,则可以通过示范和上下文学习,更轻量地完成适配。
十万小时之后,数据 开始比拼「信息量」
假设有 10000 小时数据,覆盖 100 个任务,每个任务重复 100 小时;另一批数据只有 100 小时,同样覆盖 100 个任务,每个任务只有 1 小时。
两者时长相差 100 倍,但真正包含的任务信息量,可能并没有那么大差别。
因此,在人类数据达到十万小时量级之后,Psi-R2.5 开始主动压缩重复数据:减少单个任务的数据量,在相同数据规模下尽可能覆盖更多任务;同时通过 数据管线,把拆分后的原子任务标得更细,再进行审核。
的重点,也开始从单纯增加时长,转向提高同等数据规模里的信息量。
这种变化也延伸到了评测。
Psi-R2.5 在训练过程中引入仿真评测,并设置了一个包含 50 个复杂任务的多任务真机评测集。测试时还会持续随机化任务初始状态,用来观察模型在组合泛化上的表现。
Claude Opus 5.5突袭!68万行代码一天迁完,A
Claude最新旗舰Opus 5.5在多项基准测试中跑分登顶...(109 )人阅读时间:2026-09-23
具身智能开始拼高质量数据了!灵初Psi-R2.5用强 Pai
灵初智能发布新一代具身基础模型 Psi-R2.5,通过 In...(163 )人阅读时间:2026-09-23
刚刚,高通2nm双旗舰来了,为智能体AI重造架构,手机能跑3
高通在骁龙峰会2026上发布两款2nm制程旗舰芯片:骁龙8超...(172 )人阅读时间:2026-09-23
Agent时代,CPU的价值该重估了
CPU在Agent时代的重要性被重新评估,因为AI计算配比从...(112 )人阅读时间:2026-09-23 小米MiMo Desktop桌面AI应用正式开放邀测,将AI...
 匿名报告在GitHub发布,测评显示混合GPT-6 Astr...
 黄仁勋宣布GPT-6 Astra由超10万颗GPU训练完成,...
 2026年7月,法国竞争管理局以英伟达的CUDA技术锁定AI...