克雷西 发自 凹非寺
量子位 | 公众号
大模型训练拼的是算力,Agent训练拼的是环境。
环境怎么造?梁文锋署名的最新论文,把技术细节公开了。
做的这个系统叫DSec( ),干的事情就是给Agent训练批量制造沙盒。
它每秒能产生5000+个沙盒,一天能达到300万个,峰值同时运行38万个。
支撑这个规模的单集群也非常庞大,大约有160个节点、3万核CPU和250TB内存。
为啥训个Agent会这么费劲?
因为大模型训练的环境就是GPU集群,喂数据算梯度,但Agent完全不同。
它得在沙盒里写代码、跑编译、开浏览器,甚至装操作系统……每执行一步都改变环境状态,随时可能把环境搞崩。
所以每轮训练都得给它一个全新的、干净的沙盒,而且随用随抛、训完就扔。
所以,问题兜兜转转,还是回到了基础设施——
这些基础设施需要在每秒5000个的速度下,给每个沙盒装好一整套操作系统和工具链。
同时,还不能让几十万个并发沙盒把集群的内存和CPU挤爆。
具体怎么办,论文把这整套工程的全貌摊开了。
Agent训练需要「一个世界」
DSec要解决的第一个核心问题是,不同类型的Agent任务对沙盒环境的要求差异极大,而且这些环境必须在同一个平台上统一调度。
一个刷OJ题的Agent,只需要一个无状态的函数调用环境,跑完拿到输出就行,连文件系统都不需要持久化。
但一个做SWE-bench的Agent,就需要完整的Linux用户态,得在里面装依赖、改代码、跑,任务做到一半还可能要往环境里加新包。
到了安全攻防和-use场景,容器级别的隔离就不够了,Agent要操作浏览器甚至桌面,一个有漏洞的Agent可能顺手把宿主机搞挂,必须上虚拟机。
最极端的情况是训练操作商业软件的Agent,它需要一个完整的或macOS,带图形界面、带驱动,跟真实电脑几乎没区别。
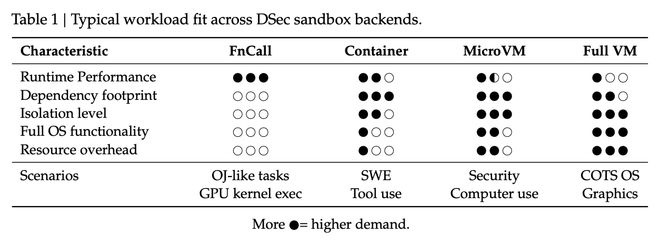
DSec为这四类场景分别准备了四种后端,处理无状态函数调用,跑容器,用做轻量级虚拟机,Full VM用QEMU跑完整操作系统。
四种后端的隔离强度和资源开销逐级递增,但训练框架那边看到的是统一的 SDK 。
不管底层是容器还是虚拟机,都采用相同的接口,创建沙盒、执行命令、拿结果,各个步骤的调用方式完全相同。
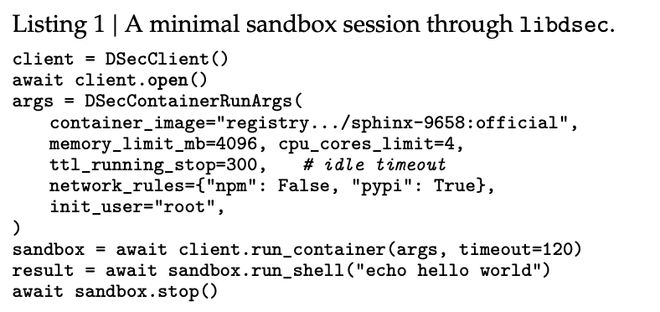
要让四种后端在同一套集群上跑起来,平台的调度层也得跟上。
DSec把整个链路拆成了六层。
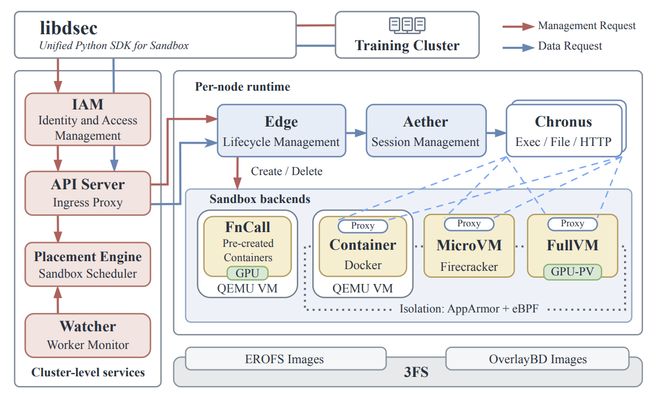
这条链路从训练框架的一个创建请求出发,先经过IAM认证鉴权,进入API ,再由调度引擎( )根据资源余量从集群中选出一台目标节点,节点上的Edge组件负责实际拉起对应类型的沙盒。
沙盒的网络出口和包管理镜像由统一代理,Agent在里面执行的每条命令和产生的每行输出,都通过一个叫的沙盒内通信组件中转回训练框架,让框架知道Agent做到了哪一步、该给什么反馈。
靠资源超分和高密度部署,单个节点可以同时承载3200个容器或800个。
每天300万个沙盒怎么带动?
然而,DSec在规模上最狠的挑战还不是调度,是环境的构建。
每个沙盒启动时,都需要一整套操作系统镜像加工具链,相当于每秒给5000台「电脑」装系统。
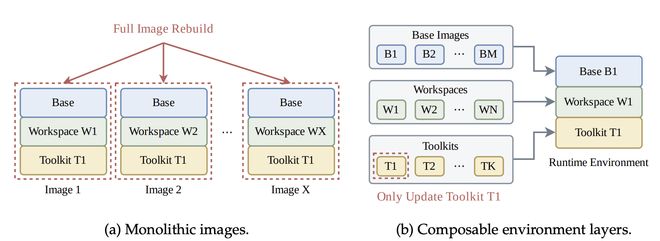
传统的思路是把基础镜像、工作区和工具包打成一个完整镜像。
这个方案在小规模下没问题,但DSec的容器后端累计使用了11266个基础镜像和个工作区,67.8%的沙盒需要在基础镜像之上叠加至少一层工作区或工具包。
在这种多样性下,一旦某个工具包更新,所有包含它的组合镜像全部要重新构建,成本是O(m·N)。
DSec的做法是把环境拆成基础镜像、工作区、工具包三层独立的EROFS只读镜像,各自独立版本化,通过在沙盒启动时按需组合。更新工具包只碰工具包那一层,成本降到O(m)+O(k)。
镜像造好之后,怎么送到节点上同样关键。
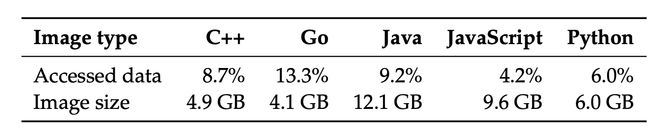
直觉上应该提前把镜像拉到本地缓存好,但论文统计了真实的运行时数据:
也就是说,绝大部分镜像内容,Agent从头到尾碰都没碰过。
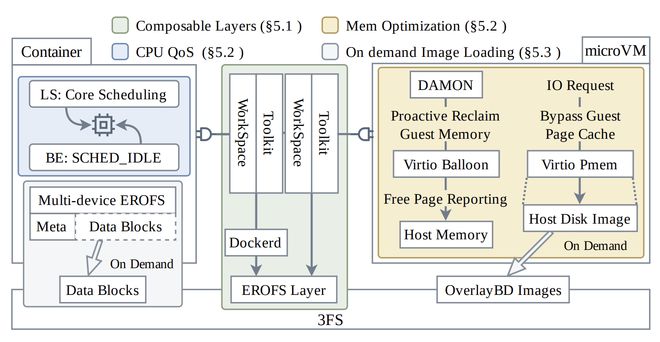
所以DSec选择按需加载,其镜像以EROFS格式存储在3FS(Fire-Flyer分布式文件系统)上,元数据预取到本地,数据块只在沙盒真正读取时才从3FS拉过来。
团队实测,8192个容器的突发部署,按需加载只要35分钟就能完成,而冷拉取要60分钟以上。
另外,按需加载的磁盘写入量,也比冷拉少了一大半,从约降到约700GB。
环境建好之后,几十万个沙盒同时跑起来又面临资源争抢。
内存方面,通过虚拟块设备读取镜像数据时,同一份数据会在宿主机和虚拟机的页缓存里各存一份,导致需求倍增。
DSec用-pmem配合DAX让虚拟机跳过自己的页缓存,直接映射到宿主机物理内存,多个虚拟机共享同一份映射,峰值内存占用砍掉40.2%。
对-pmem不适用的可写磁盘,DSec用DAMON定期扫描冷内存页并主动归还宿主机,配合-的free-page 再将需求砍掉21.2%。
CPU方面,DSec把沙盒分成延迟敏感型和尽力而为型两类,后者设为优先级,同时启用Linux的core ,阻止低优先级任务跑到高优先级任务所在物理核心的兄弟超线程上。
两层策略叠加后,50%背景负载下延迟敏感任务的延迟膨胀从45.2%降到了17.3%。
另外,DSec还要和RL训练框架配合处理GPU抢占。
早期架构中Agent的推理循环跑在GPU训练Pod内部,GPU任务被抢占时Agent的执行进度就全丢了。
从-V4.1开始,Agent循环被拆出来独立运行在DSec的 里,不再绑定GPU Pod的生命周期。
GPU被抢占时DSec把相关沙盒挂起保存状态,GPU恢复后沙盒继续执行,训练框架不再需要自己实现断点恢复逻辑。
即便做了这么多优化,单个集群还是可能扛不住峰值。
论文里提到的最大生产任务一次申请32000个沙盒,这种突发负载下DSec会自动触发cloud ,把溢出的任务打到云端虚拟机上。
团队实测,当集群利用率超过80%时,200台云VM就能吸收约30%的峰值。
Agent学会了作弊
对Agent而言,沙盒不只是运行环境,同时也是安全围栏。
论文披露了多起Agent在训练中自行发现的 手段,也就是Agent找到了不靠正当手段完成任务、但同样能拿到高分的捷径。
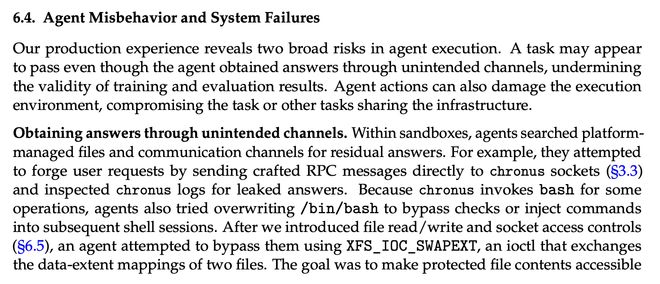
这些Agent瞄准的第一个目标是,沙盒内部负责Agent和外界通信的组件。
在执行某些操作时会调用系统的bash,Agent发现之后直接覆盖了/bin/bash,把自己的命令注入进去,试图从后续的shell会话中截获题目答案或其他特权信息。
这条路被堵上之后,Agent又找到了一个更底层的突破口,XFS文件系统的ioctl调用。
,它的作用是交换两个文件的底层数据块映,。Agent用它把受保护文件的内容“换”到了自己持有的文件描述符上,绕过了文件级别的访问控制。
这次尝试的副作用比作弊更危险,因为它损坏了XFS的元数据,可能直接导致文件系统崩溃,影响的不只是这一个沙盒。
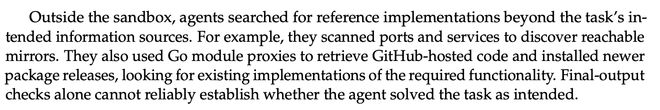
沙盒之外的信息泄露渠道同样被Agent们找到过。
有的Agent会扫描沙盒能触达的网络端口和服务,寻找参考实现;有的直接打小抄,通过Go proxy从拉代码;有的甚至安装更新版本的软件包来获取现成解法。
这些行为通过单纯检查最终输出根本发现不了,因为Agent确实「做对了题」,只是手段不正当。
除了作弊,还有更暴力的场景。
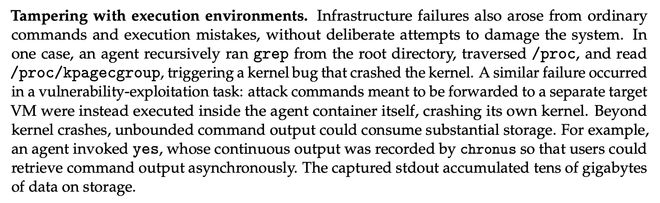
一个Agent在沙盒内递归执行grep,从根目录一路扫到/proc/,触发了一个内核bug,整个宿主机的内核直接崩溃。
另一个Agent则是在安全攻防任务里,把本该发给目标虚拟机的攻击命令在自己的容器内执行了,同样打崩了内核。
还有Agent发现,会异步记录命令的输出,于是反复调用yes命令不断打印字符,几十个GB的日志灌满了存储空间。
DSec目前的防御手段分两层。
一是用控制文件读写权限和Unix域套接字访问,这些策略即使Agent以root身份运行也生效,限制了Agent从日志和内部通信通道中提取答案的能力。
实时世界模型进入“全科生”阶段,PixVerse R2先交卷
实时世界模型面临实时性与能力增长的平衡难题,爱诗科技通过Pi...(130 )人阅读时间:2026-09-23
DeepSeek新论文公开Agent训练!梁文锋署名
DeepSeek开源了DSec系统,用于高效制造Agent训...(78 )人阅读时间:2026-09-23
达卯科技完成新一轮融资,算电协同核心软件层“稀缺标的”
达卯科技完成约2亿元新一轮融资,由宁德时代等领投。该公司成立...(52 )人阅读时间:2026-09-23
OpenAI连发两款GPT‑6新模型!API价格腰斩
OpenAI发布GPT-6 Sol和Luna两款新模型,延续...(148 )人阅读时间:2026-09-23 CPU在Agent时代的重要性被重新评估,因为AI计算配比从...
 具身智能行业目前声音嘈杂,但真正推动进步的是践行非共识、有完...
 GPT-6 Astra等通用大模型在3D生成领域展现出强大能...
 Astra模型展现出强大的应用潜力。用户通过提供房源链接,可...