出品,必属精品,时隔两个月AK大神再发文。
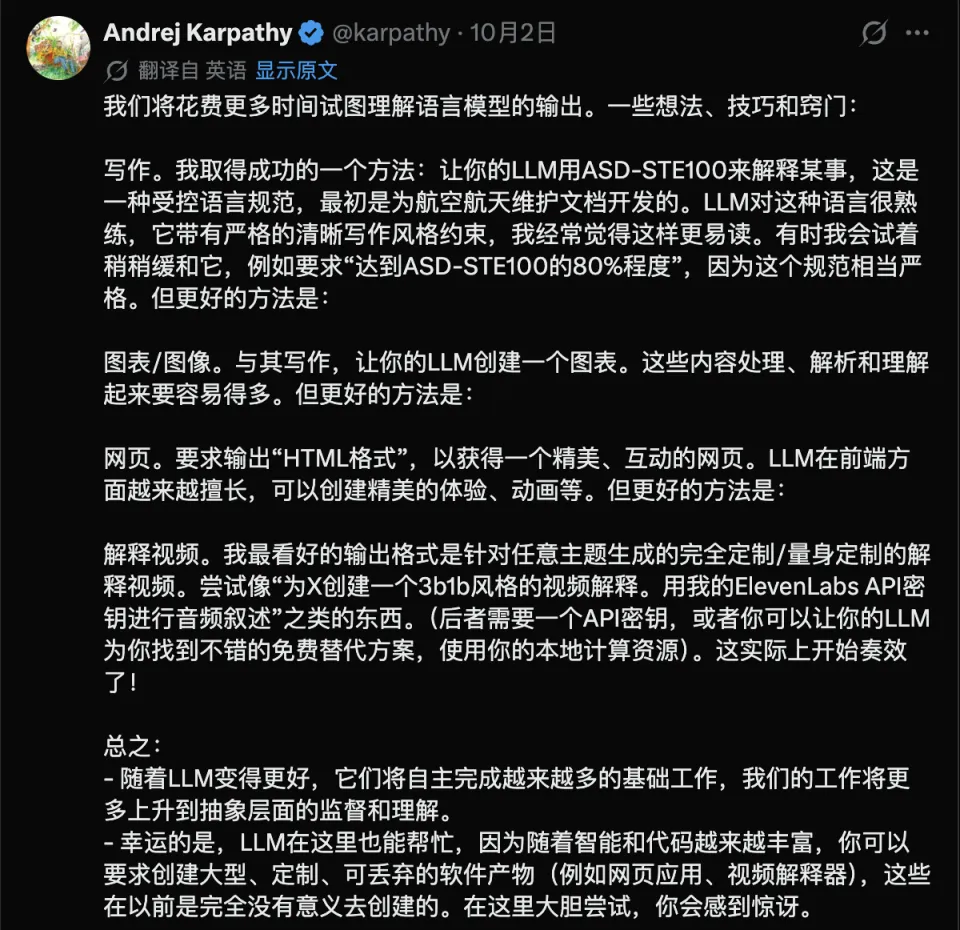
卡帕西最新推文指出,人类未来会花大量时间去理解大模型的输出,并公开了他日常让大模型把内容讲透的四套实操技巧。
随着大模型越来越聪明,繁重的底层执行都会由AI自主搞定。
人类未来的核心工作,正在全面转向高维度的审查与理解。
为了降低理解成本,卡帕西给出了从文字到视频的递进式玩法。
第一级,写作:文本受控表达
让大模型用ASD-规范来解释内容。
ASD-原本是航空维护文档使用的受控语言规范,规则极严,词汇受限。
大模型很擅长这种语言。
严格的规则限制能生成极其干净、好读的文本。
如果觉得原版规范过于严苛,也可以在提示词里要求达到80%的ASD-标准。
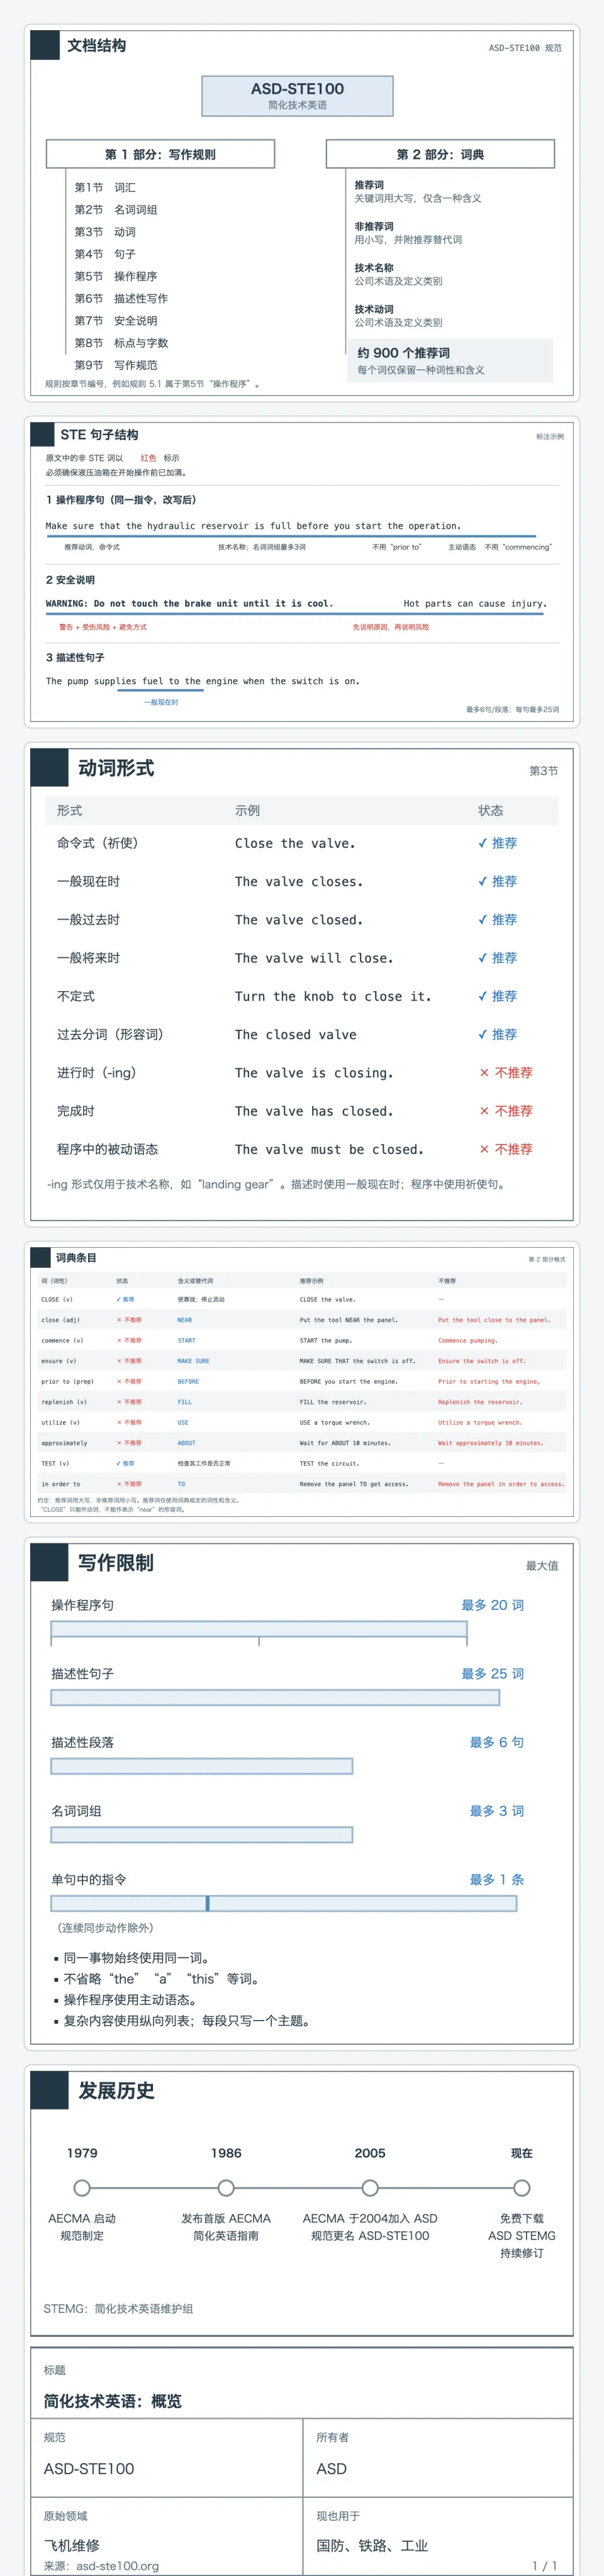
↑ 上下滑动查看完整图片 ↑
第二级:图表化呈现
比文字更好的是让大模型直接生成图表。
图形信息在处理、解析和吸收效率上,明显优于纯文本。
第三级:可交互网页
直接要求大模型输出HTML。
大模型现在非常擅长前端开发,能够快速构建出带有动画和交互体验的网页。
这个html形式在cc团队内部非常流行,几乎已经是默认的
第四级:定制解说视频。
这是卡帕西目前最看好的输出形态,也就是针对任意主题生成完全定制的解说视频。
可以直接向大模型下达指令:制作一个3b1b(知名数学科普频道 的简称,由斯坦福数学系毕业的 Grant 创立)风格的视频解说,并使用的API进行语音配音。
如果没有API密钥,也可以让大模型寻找利用本地算力的免费替代方案。
卡帕西确认,这种全自动生成视频的方案目前已经开始跑通。
卡帕西在总结中提到:
随着大模型持续进化,基础的繁重工作都会自动化。
人类的工作将上升到更高层次,专注在监督和理解。
当前智能和代码的获取成本极低。
用户可以要求大模型随手制造出庞大、定制、用完即弃的软件产物,比如专门为了解某个问题而临时生成的网页应用或视频解说。
在过去,花费成本去制造这些一次性工具完全不可行,但现在已经成为现实。
卡帕西建议大家继续向外拓展提示词的边界,结果会超出预期。
写在最后
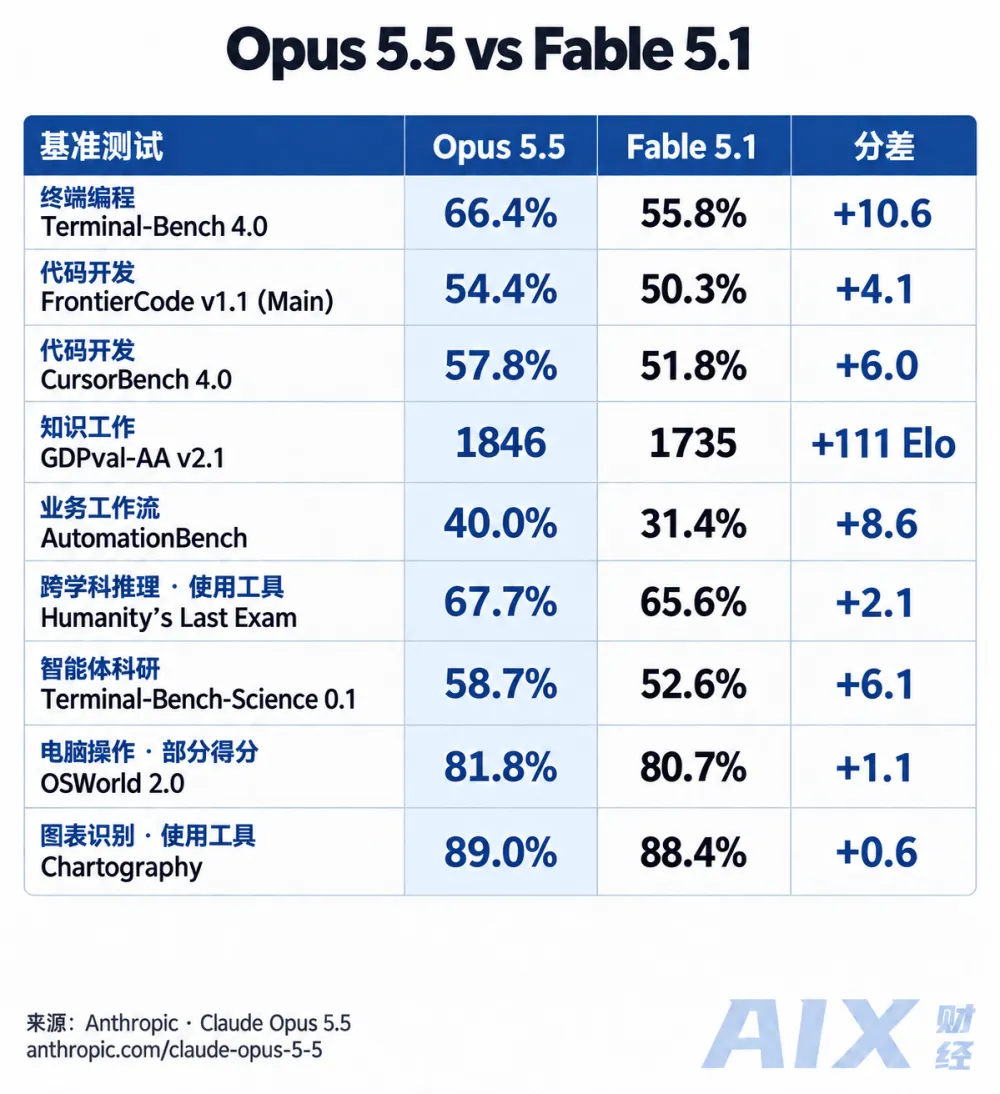
前面三条现在很多模型已经做的不错了,但是做动态视频(我指的纯代码生成视频)最强的还是opus 5.5,不过其他模型加上一些魔法也是可以的,我最近在用豆包工作探索动态视频工作流,假期结束应该会上线一篇文章,大家可以期待一下。
刚刚,Karpathy公开私藏提示词:大模型4级玩法
Andrej Karpathy分享了四套让大模型输出内容并易...(187 )人阅读时间:2026-10-04
阿里,把AI交给了90后
90后在创投圈已成中坚力量,阿里云栖大会传递出代际交接信号。...(161 )人阅读时间:2026-10-04
UC伯克利博士后顾尚定受聘上交大副教授,曾参与OpenRSI
美国加州大学伯克利分校博士后顾尚定加入上海交通大学计算机学院...(120 )人阅读时间:2026-10-04
312页《WorkBuddy大学生手册》,难的不是工具,是第
多数人因工具使用不当导致任务失败,问题在于未区分“动嘴”与“...(164 )人阅读时间:2026-10-04 今年谷歌旗下Gemini大模型表现不佳,排名跌至全球前十名外...
 豆包手机助手消费者版发布,推出“操作手机”Beta版功能,并...
 AI 技术兴起,导致许多 App 被免费或低价的 AI 工具...
 谷歌发布旗舰模型Gemini 4 Argon,在编程和知识工...