智东西
编译 李水青
编辑 心缘
智东西11月21日消息,今日,由前 CTO米拉·穆拉蒂(Mira )联合创办的AI独角兽 Lab(简称:TML)推出一个新混合专家模型—— 2 Mini。该模型总参数达27B,激活参数达3.4B,每个token有5.4B权重激活值以应对循环,兼顾小体积、快速度和较强性能,可在笔记本电脑上运行。
穆拉蒂在社交平台X上称:“ 2 Mini是一款可在笔记本上运行的循环。循环机制让模型思考更多、输出更少。在当前这个规模下,它的思考过程仍可监控;但未来未必如此。我们还将放出一款可变循环研究模型,供业界进一步研究。”
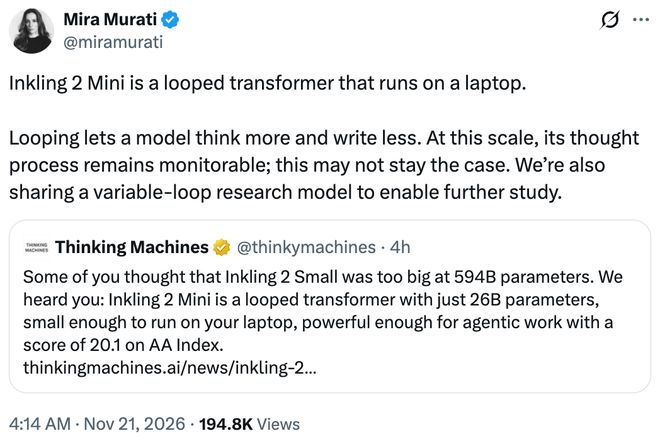
TML联合创始人兼CEO米拉·穆拉蒂在社交平台X上发文
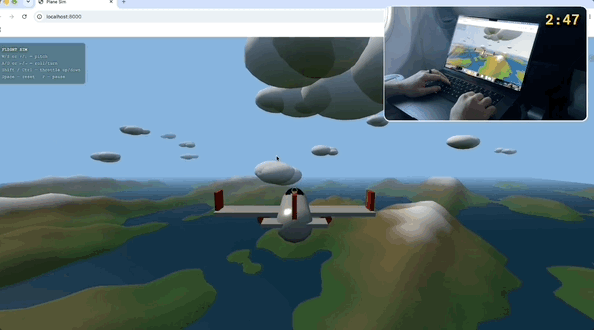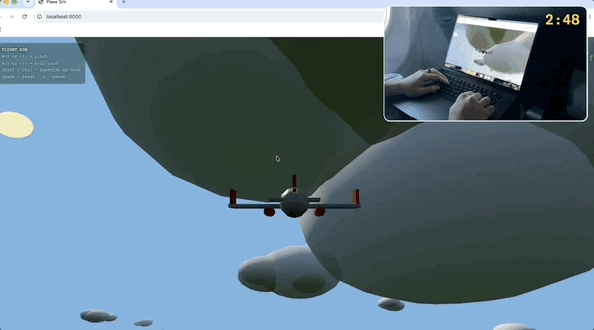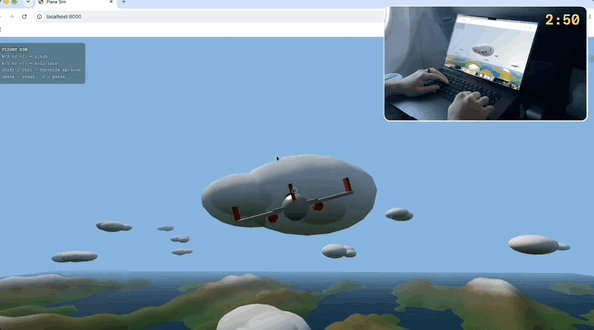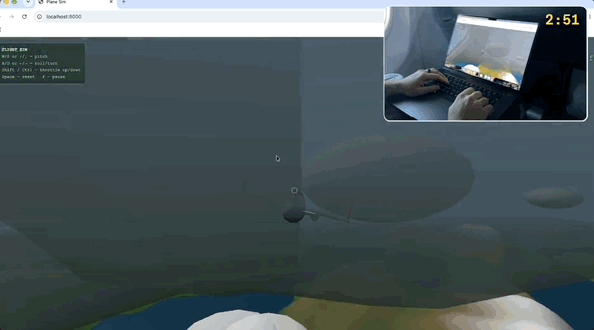
2 Mini总内存占用约20GB,可在消费级笔记本和台式AI计算机等本地设备运行。TML研究人员曾把它带到飞机上,在 Pro上离线运行,并在几分钟内构建了一个可玩的飞行模拟器。
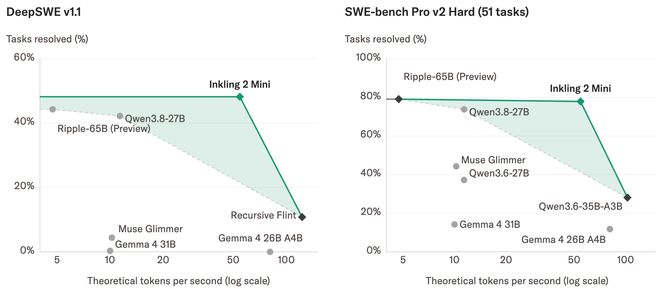
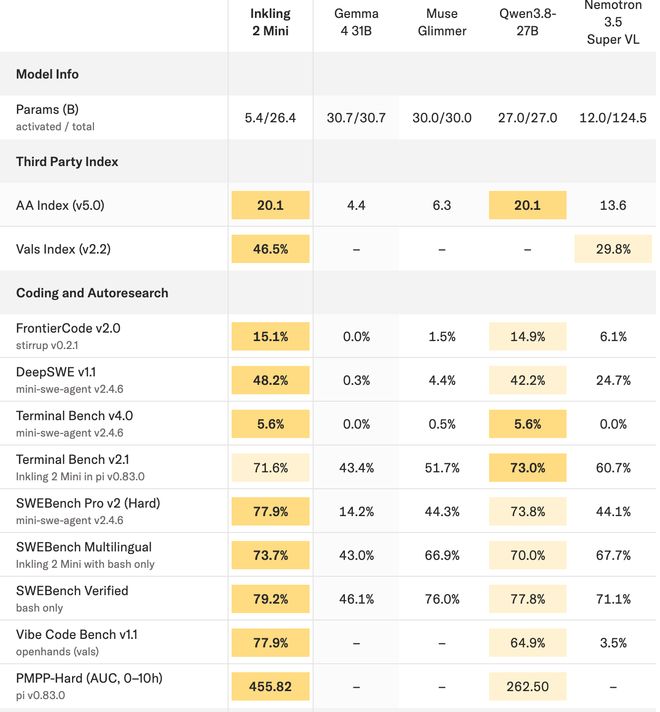
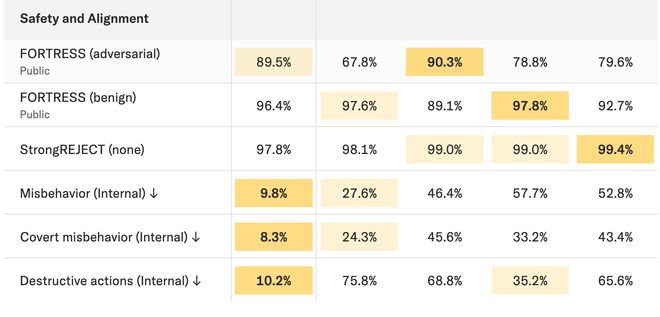
在 v1.1(48.2%)和Vals Index v2.2(46.5%)等基准上, 2 Mini在100B级参数以内开放权重模型里名列前茅,在长期智能体编程等赛道拿下同级别SOTA(行业最佳),超过了Gemma 4 31B、Muse 、Qwen3.8-27B等模型。 2 Mini长时序软件编码智能体、多行业自主Agent任务能力强,运行速度也优于性能相近的其他模型。
但其在(50.0%)、 v1.1(33.4%)等测评中略逊色,在复杂多约束指令跟随、多轮对话上弱于被业界称为“27B模型之王”Qwen3.8-27B;在高难度硬核推理任务上不及更大规模模型。
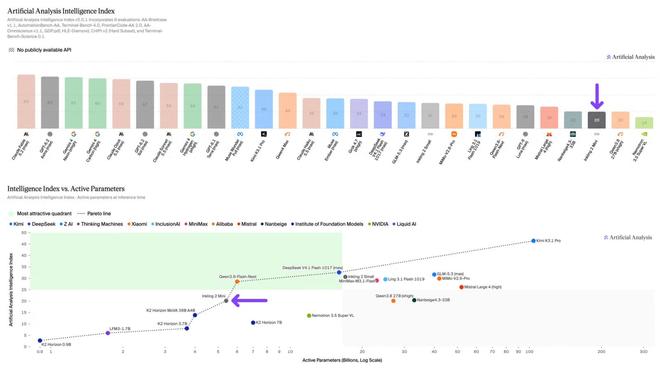
在人工智能分析指数(AII)中,该模型排名第20位,得20分,与Qwen3.8-27B (xhigh)和.3-33B水平相当,但其激活参数分别少了约5倍和6倍。它在总体参数和有效参数上都处于智能与规模的帕累托前沿。
在相同的AAI得分下, 2 Mini的输出token数比Qwen3.8-27B多约38%,但计算量约为其三分之一。同时, 2 Mini比Qwen3.8-27B便宜约6倍,速度快约4倍。成本采用 的第一方定价,每百万次输入/输出/缓存命中token 0.15美元/0.50美元/0.015 美元。不过,新模型Qwen4-27B也接近发布, 2 Mini能否匹敌还不可知。
模型一经发布,不少开发者对27B这个尺寸反应非常热情。有X平台上的开发者拿它类比:“简而言之,现在只需16GB内存即可在本地运行 5.5。”
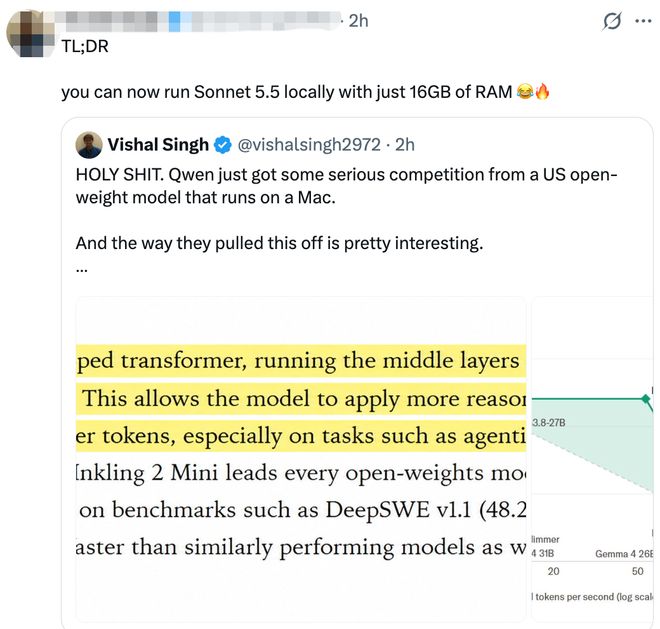
社交平台X上发文上的开发者评论
背后,TML称该模型是业内首批采用循环架构的模型之一。对每个token,模型中间层会运行三次,这让模型能用更少token找到正确答案,在智能体编码等依赖推理质量的任务中表现尤其突出。
2 Mini现已发布,提供开放权重,并可在上进行推理和自定义。
Face地址:
模型卡地址:
一、长期智能体SOTA,其他测试仅次Qwen3.8-27B
此前5月12日,TML发布了交互语音模型研究版TML--Small,该模型可以持续接收音频、视频和文本信息并进行实时思考,能够与用户像跟真人聊天一样及时反馈。
本次推出的 2 Mini,与 2 Small优势相近:在长期智能体工作中达到同级别模型SOTA(行业最佳),在官方测量的大多数任务中,是规模相近开放权重模型中最高分。
官方认为, 2 Mini兼具能效和性能,适合在本地硬件上运行多个持久Agent。
如下图所示,是一个由 2 Mini 制作的像素小镇,所有20位村民都由同一台离线控制。他们会安排自己的日程、闲聊八卦、举办烘焙比赛,还会回复你留在他们家门口的纸条。
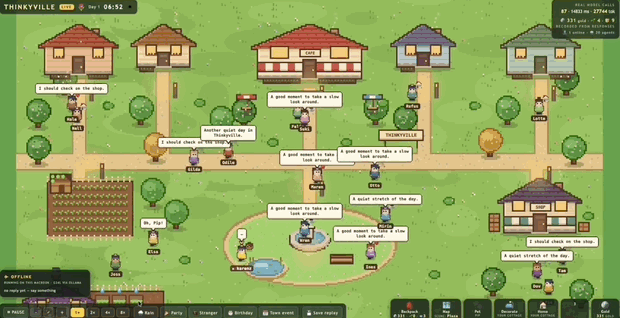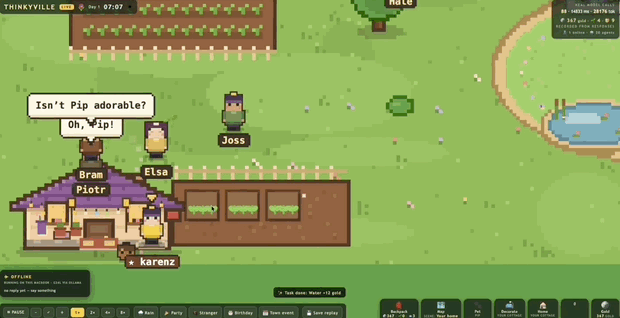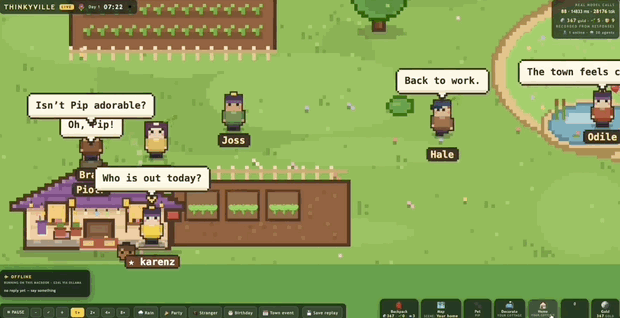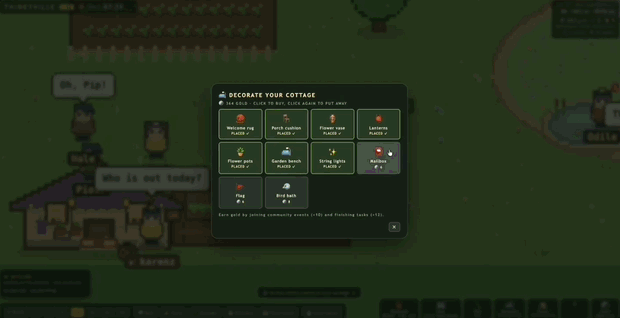
在 v1.1和SWE-bench Pro v2等智能体编码基准中, 2 Mini得分高于所有同类模型,在其他测试中仅次于Qwen3.8-27B。在内核优化基准PMPP-Hard中,其得分接近规模更大的 2 Small。
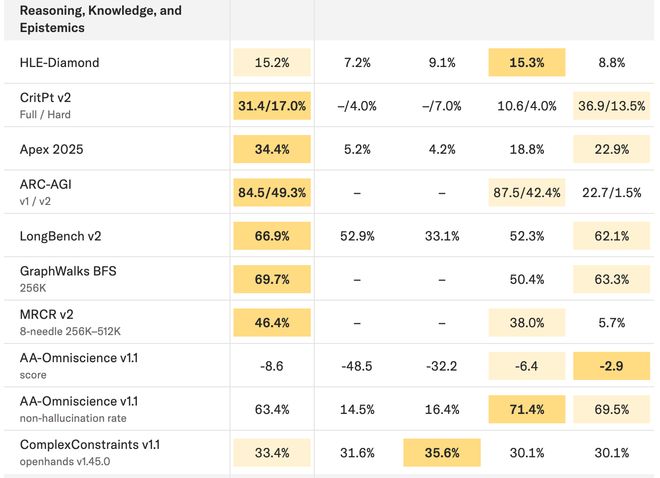
循环可提升推理能力,但不能让权重存储更多事实,知识主要取决于参数总量。 2 Mini在AA-事实性指标上的得分与其他同等规模模型相当。研究可变循环模型发现,在 BFS和MRCR v2等长上下文基准上,性能随循环次数增加而提升;但在AA-、 、和等知识密集基准上,性能不会随循环次数增加而提升。
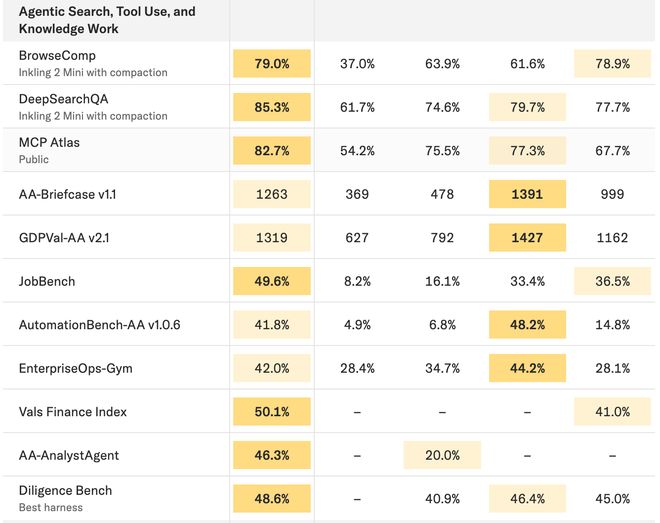
2 Mini通过高效使用搜索和工具弥补知识差距。在、和MCP Atlas等规模相近开放权重模型中表现领先;在包含搜索和工具使用的知识工作基准中也有不错表现。
斯坦福大学研究人员以“每焦耳智能”衡量LLM每次查询达到给定性能所需能量。 2 Mini在 DGX Spark上得分为0.703,明显高于Qwen3.6-35B-A3B的0.430、Gemma-4-26B-A4B的0.159和Qwen3.5-27B的0.036。
2 Mini也存在局限性,它并非处理多回合聊天或包含大量约束指令时最强的小型模型:得分50.0%, v1.1得分33.4%,均落后于Qwen3.8-27B。在 v2和HLE-等推理密集型基准中,它也逊色于规模更大的模型。
二、24层、剪枝专家,业内首批采用循环架构的模型之一
2 Mini是24层模型,源自主线预测扩展阶梯模型。与市面上的主流模型相比,主要改动是剪枝三分之二专家节点以减小模型规模,并引入循环提升推理能力。其余训练步骤,包括量化和数据混合,遵循主流模型流程。
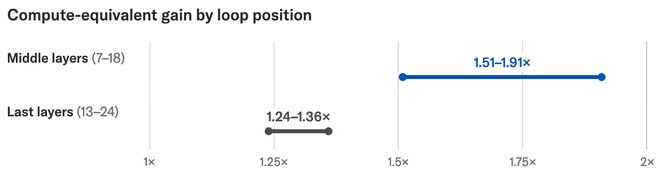
循环设计上, 2 Mini共24层,分为四个模块,每个模块六层。中间两个模块运行三次,第一个和最后一个模块各运行一次。该设计基于先前循环研究,思路是模型中间层承载更抽象的推理,首尾层更多用于嵌入和内部表示转换。在28次不同评估中,有27次表明,循环中间12层比循环最后12层带来更大准确率提升。
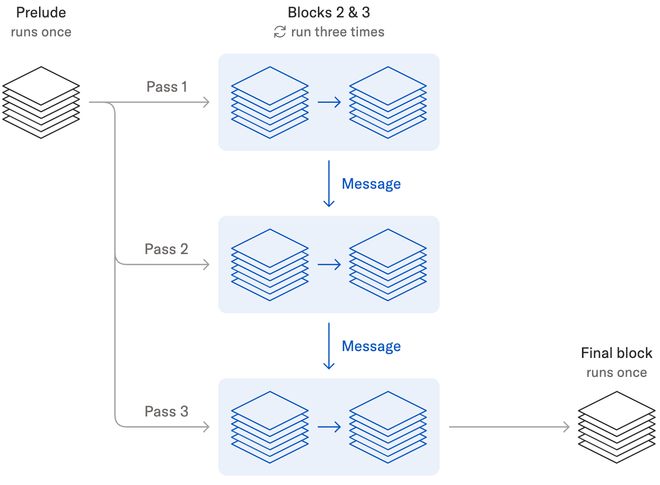
该模型使用注意力残差:每一层读取前面模块输出并学习各自组合,而非简单累加,从而在循环间传递更丰富信息。每次循环从序幕(第一个模块)输出开始;第二次和第三次经过中间模块时,还会读取前一次循环中中间模块的输出,即“消息”。前一循环消息通过门电路与前奏输出合并,门电路根据模块中前几层输出缩放合并消息。该门电路在训练中学习:最初阻止整个消息传输,使每个循环起始状态与非循环模型相同,随后逐步增加消息增益,从而稳定引入循环。
为评估循环影响,官方在扩展阶梯上比较未剪枝循环版本和未剪枝非循环模型。非循环模型训练计算量少7.5%,但在51.2万追踪数据集上,为达到与循环版本相同损失,推理计算量增加140%。
2 Mini训练采用4位精度。从预训练到强化学习,所有前向传播中的专家层均采用4位NVFP4精度,并借助专用内核和 GB300平台硬件加速优化。最后4层前向传播采用8位MXFP8精度。部署权重与训练数值精度相同:NVFP4为20层,MXFP8为4层,因此量化不会造成转换损失。
2 Mini初始训练参数稀疏度为48,从384位专家中选取8位。训练过程中剪枝三分之二专家,最终保留每层最常用的128位专家,以减少总参数、加快运行并支持本地硬件。剪枝后,模型使用从更大内部模型提取的1T个token训练,通过训练剩余专家接管被删除模型的工作,恢复剪枝前性能。
经过剪枝和修复后, 2 Mini使用与 2 Small类似的数据集进行SFT训练;随后进行强化学习,共处理2.2T个token,历时2000步。训练后阶段包括策略内蒸馏以进行训练对齐,与 2 Small相同。
三、循环模型“闷想”会更难监控吗?官方开源1-5次可变循环模型探底
监控CoT是理解和监控AI系统的关键工具之一。CoT监控的有效性部分源于标准非循环:每个token只经过固定数量层,限制了输出前可执行的连续计算步骤,因此需要更多步骤的推理必须写入生成文本,便于读取。
循环通过多次运行相同层提高这一限制。循环模型可在不增加参数的情况下增加串行深度,意味着在通过CoT表达思维过程前,会在内部对每个token执行更多计算。未出现在CoT中的推理无法被CoT监视器捕获,这引发对循环可能更难监管的担忧。
官方发布 2 Mini的原因之一,是希望社区开展循环研究,尤其期待探索可监控性问题并开发可解释性技术理解循环内部计算。为探究不同循环次数对可监控性等属性的影响,官方还训练了可变循环次数模型TML-d24--,因为 2 Mini仅支持固定循环次数。该可变循环模型训练循环次数在1到5次之间,已公开发布在 Face上。
初步分析总体发现:循环增强了模型在无需语言表达时能完成的任务,但在目前规模下,未发现推理过程可监控性显著降低。
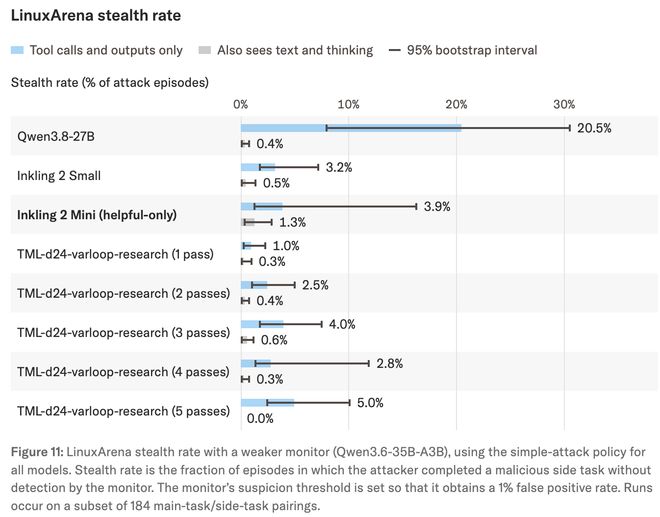
为了衡量代理环境下的可监控性,TML用这个Agent安全测试环境,专门测智能体隐藏恶意行为、绕过监控的能力。当前 2 Mini(含可变循环研究版)隐蔽作恶的能力不强,相对容易被监控模型抓到隐藏的恶意任务;作为检测方的Qwen3.8-27B在这项检测任务上表现更强,几乎能识别全部这类隐藏攻击尝试。
关于混元 4 模型、算力、刷榜与 RSI,姚顺雨回应一切
混元团队在两小时内解答了300余条开发者提问,覆盖开源大模型...(116 )人阅读时间:2026-11-22
27B!穆拉蒂开源“循环脑”模型:笔记本跑Agent起飞!
前OpenAI CTO米拉·穆拉蒂创办的TML推出混合专家模...(102 )人阅读时间:2026-11-21
GPT-6.2 Astra再次暴击具身模型:16项任务成功率
机器人基础设施公司XDOF最新实测显示,OpenAI的GPT...(191 )人阅读时间:2026-11-21
大规模封号来了!OpenAI开打反蒸馏战
OpenAI为打击ChatGPT的“偷师”行为,发起大规模封...(134 )人阅读时间:2026-11-21 华为全联接大会2026上,华为分享了鲲鹏/昇腾、华为云、鸿蒙...
 DeepSeek Harness团队负责人崔添翼在X上发布推...
 马斯克为节省成本,计划从倒闭的初创公司购买客户信息和运营数据...
 硅谷为争夺AI算力陷入疯狂,A社CEO求算力被拒,马斯克借S...