一、用有限算力追赶前沿,下一代模型将大幅扩容,小尺寸模型在路上
(1)智东西提问:随着先进AI芯片的获取日益受限,腾讯Hy目前面临的最大瓶颈是什么?是算力、训练效率,还是算法?未来Hy系列模型能否继续缩小与全球顶尖模型之间的差距?
腾讯混元:我们正在尽可能充分地利用现有资源,以追赶前沿水平。
(2)网友提问:未来Hy4.5是否计划将模型参数规模扩大至1.5万亿至2万亿?
腾讯混元:下一代Hy模型肯定会进一步大幅扩大规模。
(3)网友提问:你们认为当前Hy系列模型已经接近能力上限了吗?未来更强的模型是否必须增加参数量,还是可以保持现有规模,通过后训练进一步提升能力?
腾讯混元:我们相信Hy4仍然有很大的提升空间,尤其是在后训练方面。我们正在大力投入大规模强化学习(RL),同时持续改善用户体验和模型安全性。敬请期待后续更新。我们还计划训练规模更大的模型。我们坚信的重要性,并将继续坚持这一方向。
(4)网友提问:字节跳动、Kimi等公司似乎正在向3T甚至5T参数的超大规模模型进军,而腾讯Hy系列仍处于700B左右的规模。为什么选择这样的路线?你们如何看待参数量对模型智能水平的影响?未来是否计划进一步扩展模型规模?
腾讯混元:Hy3和Hy4已经证明,规模较小但训练扎实的模型往往也能超越更大的模型。更重要的是,小尺寸模型的成本更低,而且在研发过程中,我们还能学到更多、积累更多经验。
(5)综合多位网友提问:腾讯未来是否会推出Hy4-mini,以及24B—31B规模的稠密模型?是否有计划推出能够在24GB显存、64GB—128GB内存设备上运行的小尺寸模型?对于100B参数以下、专门面向编程任务优化的模型,又有哪些规划?
腾讯混元:Hy4-mini已经在开发路线图中,未来还将推出更多小型模型。 对于24B—31B规模的稠密模型,团队正在考虑;对于更小规模的稠密模型,也有推出的可能,但目前可能不会专门开发100B参数以下、针对编程任务优化的模型。
在本地部署方面,混元团队确认未来会推出面向24GB显存设备的模型,也会继续开发适合64GB—128GB内存设备运行的模型。 对于与当前模型规模相近、经过Q4量化后适合128GB内存设备运行的开放权重模型,团队同样给出了肯定回答。
此外,Hy4 flash还将继续更新,团队正在优化Flash级模型的预训练和后训练方案。 至于Hy4和Hy4 flash的定位,团队表示,两款模型均为通用模型,并非专门面向编程任务训练。
(6)综合多位网友提问:除了语言模型,腾讯是否会推出更小的开源图像模型、升级视频生成和翻译模型?Hy4能否支持方言识别、实时语音翻译?在持续学习和通用人工智能(AGI)方面,又取得了哪些进展?
腾讯混元:对于图像生成,团队表示正在考虑推出更小的图像模型,同时建议开发者近期关注视频模型的相关动态,但没有透露具体发布时间。
在翻译方面,团队确认Hy-MT模型即将升级,并表示会认真考虑用户提出的中文网络小说翻译建议。
对于方言识别和实时语音翻译,混元团队坦言,Hy4目前尚不支持音频理解或音频生成,但用户可以尝试腾讯元宝提供的语音识别(ASR)和语音合成(TTS)功能,或许能够满足相关需求。
关于持续学习,团队认为这是一个很有前景的研究方向,目前正在积极开展相关研究,但没有披露具体成果。
此外,有网友引用AGI能力分级体系,询问Hy4当前达到了什么水平。混元团队成员给出了个人判断——“大约是2.5级。”
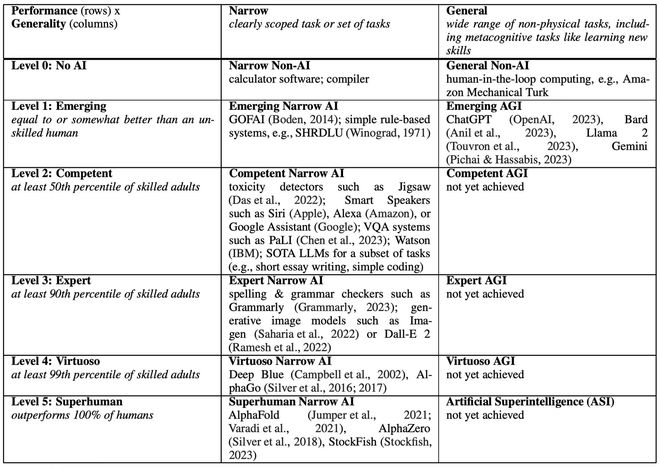
提出的AGI能力分级体系(图源:)
二、架构选择曾经反复权衡,MoE并非越稀疏越好
(7)网友提问:腾讯是否计划推出面向低延迟任务的Flash-Lite小尺寸模型?与mHC和门控残差(GR)相比,iHC有哪些优势?为什么Hy4 flash选择滑动窗口注意力(SWA),未来是否会尝试QSA等其他注意力机制?
另外, Face上旧版开放权重模型的许可证是否也会更新,以支持欧洲经济区(EEA)用户?
腾讯混元:很棒,有很多技术问题。
第一,会的,敬请期待一款技术先进的Flash-Lite模型。
第二,与mHC和GR相比,iHC要简单得多,能够以更低的成本实现相近的性能。
第三,SWA能够将KV Cache规模缩小4倍,从而显著降低推理服务成本。
第四,当然!我们对各种架构创新都持开放态度。
(8)网友提问:参与开放权重模型研发和开源社区贡献,是一种怎样的体验?
腾讯混元:为开源社区作出贡献是一件非常有成就感的事情,尤其是看到这么多人关注我们的工作时。
(9)网友提问:研发过程中,你个人经历过最困难的时刻是什么?
腾讯混元:对我来说,最困难的是从Hy3扩展到Hy4的过程。
我们没有按照我希望的程度,对训练数据开展足够多的详细消融实验,因此在开始训练时仍然存在很多不确定性。说实话,训练刚开始的时候,我非常紧张。
幸运的是,最终的训练过程出乎意料地顺利。那种感觉就像孤注一掷地赌了一把,结果真的赢了。
(9)网友提问:如果可以许一个愿望,你希望未来的大语言模型能为你做什么?
腾讯混元:作为一个十足的美食爱好者,我希望未来的大语言模型能够创造全新的食谱,而且真的能确保做出来的味道完全符合我的喜好。
(10)网友提问:在最终采用的Hy4架构之外,腾讯Hy团队曾认真考虑过、但最终放弃的最有竞争力的替代架构是什么?为什么放弃?
腾讯混元:我们此前曾在GQA和MLA之间反复权衡。
MLA的计算强度明显高于GQA,导致在推理GPU上进行推测解码( )时,计算能力成为性能瓶颈。
不过,在KV Cache大小相同的情况下,MLA能够提供比GQA更好的模型质量。
幸运的是,随着DSA的引入,我们得以降低MLA在解码阶段的计算强度。这最终改变了两种架构之间的权衡结果,让我们决定采用MLA。
(11)网友提问:从Hy4的原始架构发展到Hy4 flash时,你们如何决定哪些网络层或架构组件应该保留?每一次调整神经网络层的决定,主要依据什么?
腾讯混元:Hy4 flash继承了Hy4的多项技术,包括iHC、门控MLA和DSA,同时引入了混合SWA、和等新的架构组件。
这些设计选择背后,都有团队在不同模型规模的实验中积累的大量结果,以及模型架构与推理系统的协同设计。
(12)网友提问:额外的参数密度对模型智能水平有多重要?你们是否测试过将Hy4 flash调整为156B总参数、8B或5B激活参数的情况?模型质量会下降多少?
腾讯混元:我们进行过不同MoE稀疏度的实验,类似于MAI--1论文中的研究,并得出了大致相同的结论。
在激活参数量固定的情况下,提高稀疏度能够改善计算效率。因此,这条技术路线是有效的。
但是,156B-A8B或A5B属于完全不同的权衡方式。这种做法是在保持总参数量不变的情况下,减少激活参数量。我预计,这会显著损害模型质量。
激活参数量本质上决定了模型的计算预算。提高稀疏度可以挽回一部分计算效率,但无法完全弥补激活参数减少的影响。
归根结底,减少激活参数意味着更少的计算投入,以及能力更弱的模型。
(13)网友提问:我一直希望有实验室能够把MoE稀疏度推向新的高度,比如开发一款200B总参数、3B激活参数的模型,还可以结合。它可能表现很差,也可能出乎意料地优秀,但推理速度应该很快,MoE架构究竟可以做到多稀疏?
腾讯混元:我的看法是,过度稀疏的MoE架构不利于推理。这种架构会消耗大量GPU显存,却无法充分利用GPU的计算能力(FLOPs)。
实际上,我们完全可以构建一个总参数规模相同、但激活参数更多的模型,同时实现相同的推理吞吐量。
(14)网友追问:对于数据中心的高并发推理服务,这个观点确实成立。但在本地部署中,情况有所不同。受限于内存带宽,A12B模型在Strix Halo和DGX Spark设备上的运行速度较慢,而一些激活参数更少的模型反而表现不错。
腾讯混元:我理解你的观点。对于端侧模型,我们会采用不同的设计思路,更紧密地结合边缘设备GPU硬件的特点,共同设计模型架构。
(15)网友提问:你们是如何确定Hy4 flash中约63.5B的参数与约155.5B的神经网络主干参数之间的分配比例的?论文中提到,20%—25%左右的比例对其模型较为理想。你们是否也在实验中发现了类似规律?
腾讯混元:我们发现,参数占总参数量(包括本身)约1/3时,能够达到一个最佳平衡点,对应U形曲线的最低点。
(16)网友提问:如果让Hy4完全自主运行,它目前是否具备通过递归自我改进(RSI)开发下一代模型的能力?你们是否建立了相关基准测试,能够超越简单的运行时长和工具调用次数,评估模型真正的自主研发能力?
腾讯混元:我们的RSI能力仍处于早期阶段。我们已经开发了多个内部评测基准,用来评估RSI的关键能力。此外,我们也正在开发Hyra 3.0,不断为模型研发打造更好的可复用工具。
(17)网友提问:未来Hy系列模型最主要的能力提升路径是什么?
腾讯混元:我们当前的首要任务,是打好坚实的基础、提升模型智能水平,并与旗下产品紧密协作,提供更好的用户体验。
(18)网友提问:和Hy4 一样,Hy4正式版有时也会花费过长时间进行推理。这种过度思考问题是由强化学习的奖励机制设计导致的,还是与训练数据分布有关?模型能否学会在适当的时候停止思考?
腾讯混元:Hy4的目标是最大限度提升模型智能水平,因此,较长的思维链(CoT)是一个已知问题。
不过,这也使我们能够通过蒸馏,将Hy4的能力迁移到Hy4 flash,并实现良好的成本效率。对于Hy4 flash,我们使用强化学习来确保其思维链保持较短。
(19)网友提问:当模型编造错误的命令语法或参数标志时,命令行工具(CLI)很容易出错。你们是如何通过强化学习提高工具调用准确性,同时避免模型丢失上下文的?
腾讯混元:为了提高工具调用的准确性,我们在强化学习数据上投入了大量精力,其中包括模型容易出错的高难度案例。
我们还采用了细粒度奖励机制,对关键细节上的错误施加更严厉的惩罚。
在上下文保持方面,我们正在不断延长强化学习训练所使用的上下文长度,并专门提升模型的上下文压缩能力。
(20)网友提问:在不泄露内部信息的前提下,能否介绍一下Hy4的Agent编程任务主要集中在哪些场景?
例如3D建模、大型单体代码仓库、短时间零样本编程、文档编写与代码更新、代码及注释和文件结构的可理解性,以及多轮开发中的代码整洁度。模型能否在无人干预的情况下自主执行数百轮操作,同时保持代码质量?
腾讯混元:我们覆盖了上述所有场景,并且非常重视任务的多样性。
(21)网友提问:Hy4 flash如何确定不同网络层和专家的量化精度?在量化过程中,如何保证MoE路由器的稳定性?如果进一步减少激活参数量,模型的哪些能力会受到影响?
腾讯混元:我们会根据网络层对量化的敏感程度分配精度。例如,down投影通常更加敏感,因此需要更多比特。相比为每个专家分别设置精度,我们更倾向于按张量分配,以提高推理引擎的兼容性。
在量化感知训练(QAT)中,我们会将MoE路由器与模型其他部分一起训练,保持路由器稳定。 相比LoRA等方案,我们更倾向于全参数QAT,以获得更好的模型质量,但目前尚未开展LoRA相关实验。
如果将激活参数量从12B减少至3B,我们预计推理深度、长上下文追踪能力和工具调用可靠性会率先退化。
此外,参数不计入12B激活参数之中。模型每一层都使用独立的N-gram表,在内存预算允许的情况下,我们会优先考虑模型能力。
(22)网友提问:最近小米MiMo团队详细公开了模型训练过程。你们如何看待这种做法?如果方便透露,MiMo的后训练方法与你们的方案接近吗?还是在训练成本、数据规模、任务类型比例等方面存在明显差异?
腾讯混元:很高兴看到MiMo团队分享他们的研究工作,我们的强化学习训练规模更大。
(23)网友提问:未来是否有可能推出采用循环式MoE架构的模型?
腾讯混元:完全有可能,敬请关注。
(24)网友提问:我看到了Hy4 flash在大量PHP代码仓库上的测试结果。它很好地完成了一些Shell和任务,例如ZFS数据集迁移这样的特殊场景。你们是如何处理PHP类型推断中的特殊问题的?
腾讯混元:更好的训练数据、多样化的内部评测,以及“不针对基准测试刷分”(non-)。
(25)网友提问:为什么你们没有公布GPQA 、τ-bench、、SWE-bench等常见基准测试的成绩?是否有什么具体原因?
腾讯混元:我们展示的是近期较为先进的基准测试结果,例如’ Last Exam、等。你提到的那些基准测试推出的相对较早,分数已经趋于饱和。
(26)网友提问:你们是否计划从零开始训练三值模型( Model),从而大幅提高推理服务效率?
腾讯混元:目前,我们没有从零开始训练三值模型的计划。
(27)网友提问:你们在创意写作和内容可读性方面投入了多少关注?如果有一款模型在解释问题时,表达更加清晰、易于理解,这将是促使我放弃Qwen3.8 Flash Next、转用其他模型的重要原因之一。
腾讯混元:我们同样认为创意写作和可读性非常重要,正在将其列为重点改进方向。 我们已经在这方面做了不少工作,但仍然有改进空间,有时候,一个好的例子胜过五段文字。
我们非常重视模型在实际使用中的表现,写作质量和可读性都是其中的重要组成部分。我们正在积极改进这两方面的能力。
(28)网友提问:我注意到,大语言模型的写作能力有所下降。以前我会使用 3.5编辑文本,但现在已经不再使用 5.5。我发现,只有 Pro生成的代码文档勉强符合要求。Qwen3.6的写作能力也比Qwen3.8更好。这种现象是因为大模型越来越偏重代码训练,还是由于过拟合,或者其他原因?
腾讯混元:我们也注意到了这一现象。我们认为,这可能与模型的训练目标有关。
我们希望自己的模型能够写得更像人类,表达更加自然,而不是千篇一律、充满模板感。我们正在努力改善这一问题,敬请期待。
三、仍会坚持开源,单一榜单并不能决定模型能力
(29)网友提问:腾讯会继续保持开源,还是像Meta一样转向闭源?如果腾讯未来研发出了AGI,或者能力最强的AI模型,还会选择开源吗?
腾讯混元:就目前而言,是的,我们会继续保持开源。
(30)网友提问: 榜单对美国闭源模型存在明显偏向,这在多大程度上损害了腾讯Hy以及其他中国前沿模型实验室的商业利益?
腾讯混元:单一网站并不能真正决定一款模型在现实世界中的采用情况。我们会参考各种不同的评测,包括内部基准测试、公开评测、第三方评测,以及真实用户反馈。
要真正判断一款模型的表现,需要看完整的评价结果。归根结底,这才是用户真正关心的。
(31)网友提问:除了通过研究论文交流,你们是否也会与其他开源大模型实验室交流沟通?
腾讯混元:我们在积极向开放的大模型社区学习,也希望将自己的更多研究成果回馈给社区。
(32)网友提问:你们团队在日常工作中是如何使用大语言模型的?使用的是开源模型、腾讯自己的内部模型,还是其他闭源模型?
腾讯混元:我们会使用优秀的模型,无论它们是否开源。当然,Hy系列模型也在内部被广泛使用。
(33)网友提问:腾讯是否计划推出针对不同硬件配置的量化版本,或者参与支持低显存部署的项目,让Hy4也能在显存有限的设备上运行?另外,你们是否也感受到需要像Kimi一样,限制或移除模型网络安全能力的压力?
腾讯混元:我们正在推进Hy4对的适配,相关支持很快就会上线。我们为了负责任地开源,对模型的部分网络安全能力进行了限制。我们认为,这样做是有必要的。
(34)网友提问:EXL3量化对于配置较低的硬件进行本地推理非常有帮助。腾讯是否计划支持这种量化格式?
腾讯混元:目前,我们没有适配EXL3版本的官方计划。不过,鉴于模型权重已经开放,我们相信开源社区很快就会陆续推出相应版本。
(35)网友提问:我刚开始了解这款模型,还没有尝试使用。请问它的参数规模以及内存、显存要求是多少?
腾讯混元:你可以在M5 Max和128GB的Spark设备上运行Hy4 flash模型。
(36)网友提问:如果最终目标是构建端侧Agent,你是否建议开发者现在就开始,在PC或Mac上运行较小的本地模型,搭建Agent ,并测试真实应用场景?
腾讯混元:我们建议现在就开始。我认为,本地部署始终会面临效率方面的挑战,而相关技术也会持续迭代。
(37)网友提问:腾讯未来是否会优先投入面向科学研究、特别是生物学任务的强化学习?尤其是Hy4 flash至500B参数规模之间的模型。
腾讯混元:我们正在积极投入面向科学研究的强化学习,同时也高度重视安全性。
(38)网友提问:你认为,什么将开启人工智能的下一个时代?是模型架构上的突破、更多或更高质量的训练数据,还是其他因素?
腾讯混元:我们始终认为,数据和评测是实现通用人工智能(AGI)最重要的工具。数据决定模型能够具备哪些能力,而评测则引导我们朝着正确的方向前进。
(39)网友提问:现在应该如何入行,成为一名AI工程师?
腾讯混元:现在,你可以直接问AI如何开展AI工程工作,或者如何学习AI。
(40)网友提问:如果不看模型跑分,而是根据团队技术实力、研究质量等因素,你会如何评价、智谱、月之暗面、阿里巴巴等其他开源模型实验室?如果一定要选出前三名,你会如何排序?
腾讯混元:我才不上这个当呢,大家都很优秀。
四、主动限制部分网络安全能力,Hy4漏洞发现能力较强,漏洞利用能力相对较弱
(41)网友提问:通常情况下,大量安全对齐训练会导致开源模型拒绝执行基本的渗透测试、逆向工程或CTF任务。你们是如何避免模型对这些具有双重用途的编程请求过度拒答的?
腾讯混元:在网络安全训练方面,我们侧重于防御性任务、漏洞分析与修复,同时排除涉及漏洞利用和攻击性攻击的数据。我们还会进行红队评估,以评估潜在风险。
避免过度拒答仍然是一个需要改进的重要领域。
(42)网友提问:Hy4的系统卡提到,腾讯有意筛选网络安全训练数据,仅保留与漏洞复现和修复有关的数据,移除了漏洞利用、逆向工程等进攻性训练内容,限制模型的网络安全能力,是否反而让防御人员付出了代价?
腾讯混元:根据我们的评测,Hy4的漏洞发现能力较强,而漏洞利用能力相对较弱。
(43)网友提问:为什么要从训练数据中移除网络安全红队相关内容?这样做可能削弱模型能力,却无法带来实际的安全收益。你们是否考虑过其他替代方案?
腾讯混元:过滤这些数据是一项更基础的措施,同时还需要配合经过训练的安全防护机制,在必要时拒绝相关请求。这些都是为了实现负责任的开源。
(44)网友提问:你们是否曾使用过去发生的AI对齐失败事件,无论是腾讯自己遇到的,还是其他实验室公开披露的案例,作为模型训练数据或评测目标?
腾讯混元:这些案例只用于评测环节,以便进行跟踪和监测。
(45)网友提问:在内部运行模型时,例如训练、评测和部署阶段,特别是在Agent任务中,你们会采取哪些网络访问控制措施?
腾讯混元:我们会使用允许列表和阻止列表。在模型评测过程中,由于已经发现前沿模型存在多种攻击方式,我们需要反复修复、调整测试环境及相关访问控制列表。
此外,我们会在整个训练和评测过程中,持续监测潜在的黑客攻击和模型对齐问题,并在发现问题时修复相关环境。
黎曼猜想真被Claude证明了?陶哲轩邓煜等菲尔兹奖得主回应
Anthropic数学家莱文特·阿尔珀格宣称与Claude合...(124 )人阅读时间:2026-11-22
腾讯姚顺雨团队深夜回应一切:算力不足、模型刷榜、雷霆大思考
腾讯Hy团队在算力受限下,正通过充分利用现有资源追赶AI前沿...(155 )人阅读时间:2026-11-22
谷歌重磅论文:内部已实现RSI!Opus经验喂给Gemini
谷歌推出“自我改进记忆”(SIM)机制,使AI模型能继承经验...(172 )人阅读时间:2026-11-22
对AI说「下次注意」没用!马斯克麾下工程师:把纠错锁进代码
AI写代码速度远超人类审核极限,单月交付PR数量激增。Spa...(172 )人阅读时间:2026-11-22 Grok Bot由SpaceXAI开发,使用简单,用户可通过...
 Kimi K3开源后引发“部署大模型”热议,其全球性能第三且...
 2026年初,多个27B大模型4-bit量化版本普遍将Gat...
 今年Agent赛道多关注个人效率,但企业市场需处理复杂流程与...