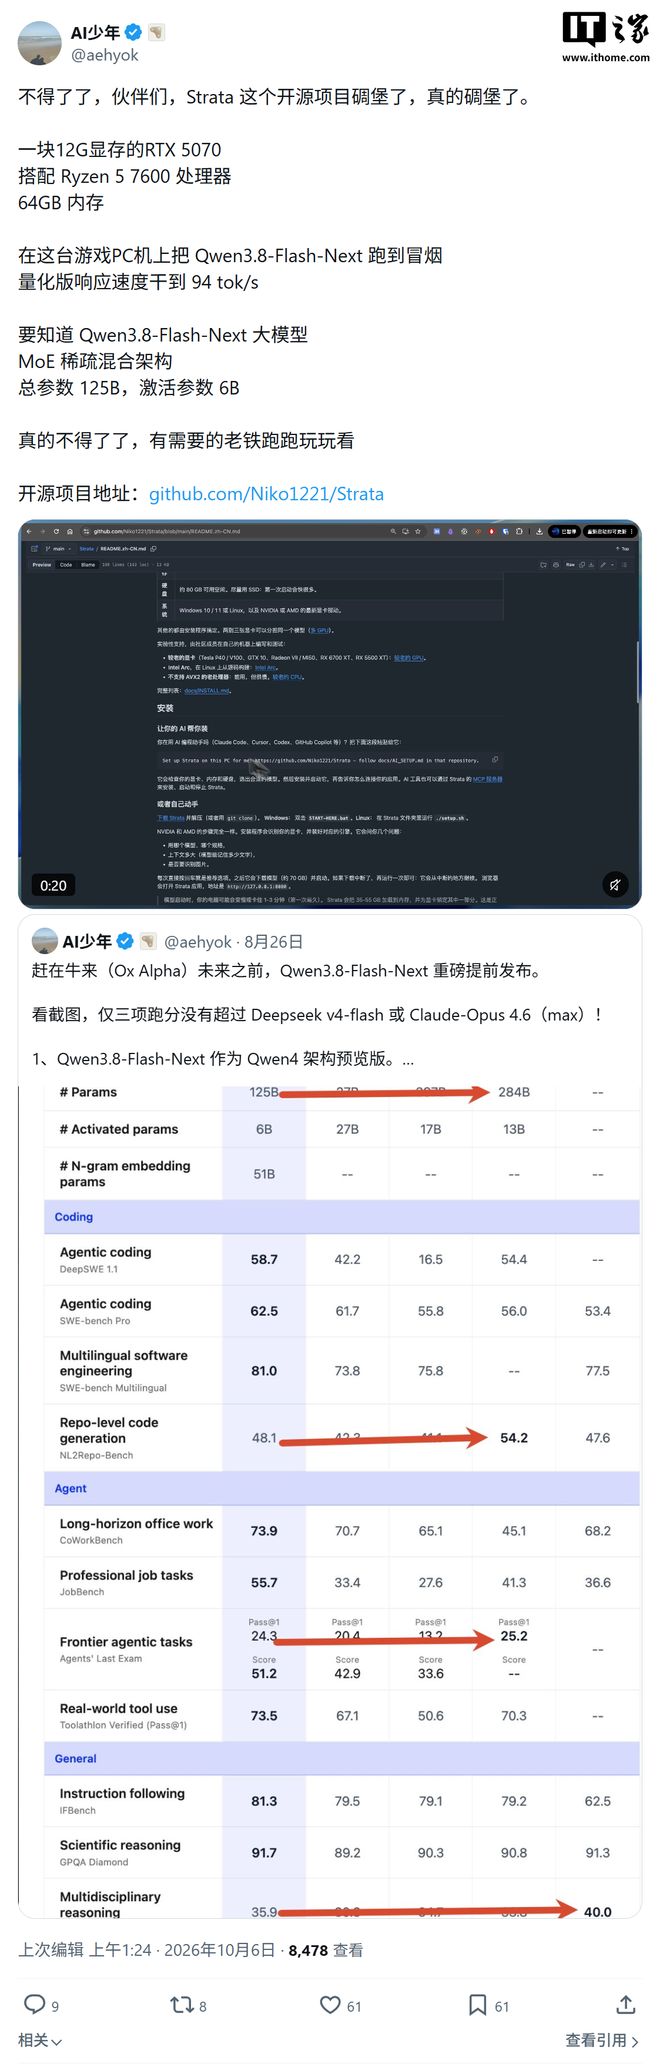
IT之家 10 月 6 日消息,科技媒体 今天(10 月 6 日)报道,报道称开发者 开源推出 引擎,可以在 12GB 及以上显存的消费级显卡上,运行量化的 Qwen3.8-Flash-Next 模型(1250 亿参数)。
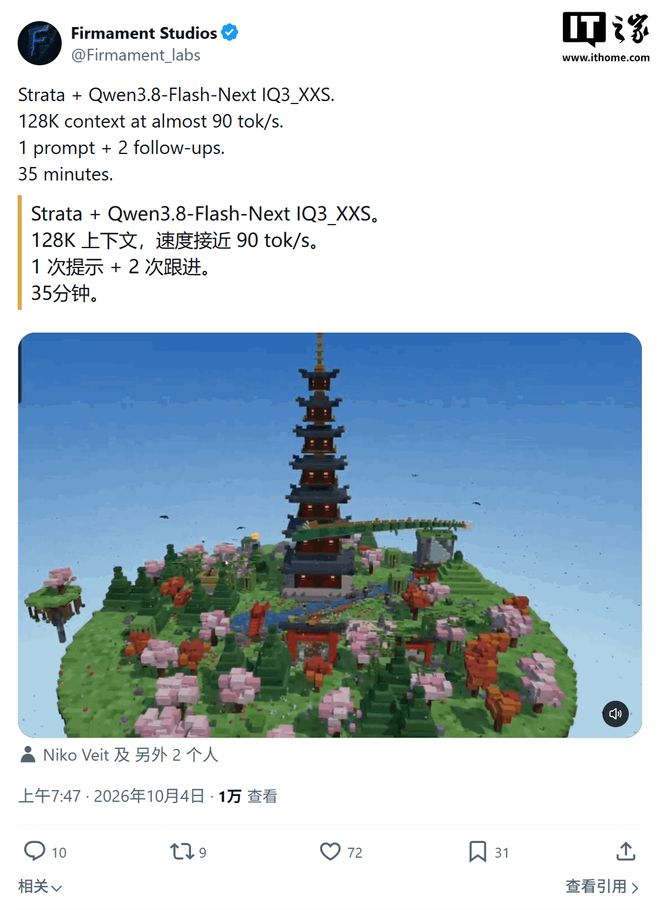
IT之家注:Qwen3.8-Flash-Next 模型是阿里巴巴 Qwen 团队于 2026 年 8 月推出的多模态混合专家(MoE)模型的压缩版本,配有 125B 参数,另含 51B 参数的 n-gram 嵌入表,原生支持 262K token 上下文长度。
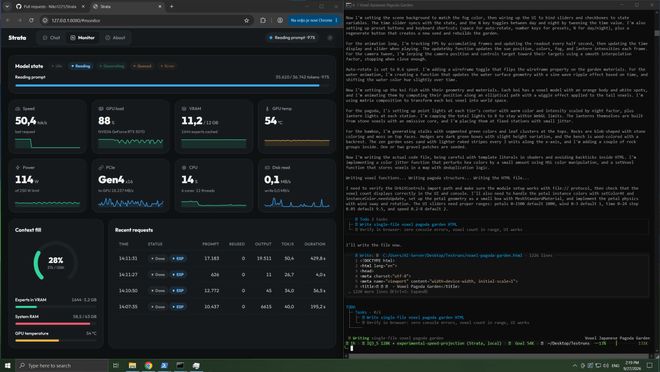
为了降低显存占用,主要采用两项关键技术:其一是将 MoE(混合专家)模型整体载入 RAM,仅将高频使用的专家模型载入 VRAM。其二使用轻量模型进行投机解码,预测下一 Token 以加速推理过程。
硬件要求方面,运行 Qwen3.8-Flash-Next 需满足最低配置:12GB 以上 VRAM 的 或 AMD 显卡、32GB 以上 RAM、80GB 以上存储空间(推荐 SSD)、 10/11 或 Linux 系统。
性能方面,在 RTX 5070(12GB VRAM)、Ryzen 5 7600、64GB RAM 配置下,2 比特量子化版 Q2_0 达到 94 词元 / 秒推理速度,3 比特量子化版 IQ3_S 为 53 词元 / 秒。AMD RX 9070 XT(16GB VRAM)环境下,Q2_0 版本达到 60 词元 / 秒。
英伟达主机性能表现:
硬件配置: RTX 5070(12 GB 显存),AMD Ryzen 5 7600,64 GB 系统内存。
量化版本(Size)写答案速度( )阅读提示速度(Reads your ) 个词元 / 秒2,650 个词元 / 秒 个词元 / 秒2,090 个词元 / 秒 个词元 / 秒1,750 个词元 / 秒 个词元 / 秒1,620 个词元 / 秒 个词元 / 秒2,180 个词元 / 秒
AMD 主机性能表现:
硬件配置:AMD RX 9070 XT(16 GB 显存),AMD Ryzen 9 3900X,47 GB 内存。
量化版本(Size)写答案速度( )阅读提示速度(Reads your ) 个词元 / 秒1,160 个词元 / 秒 个词元 / 秒1,110 个词元 / 秒 个词元 / 秒1,420 个词元 / 秒
这里的“写答案”对应生成回复(输出)的速度,“阅读提示”对应处理你输入的 (上下文)的速度。
参考
苹果10月下旬或再推一批新品 但第二场Mac发布会尚无确证
苹果预计在10月下旬再发新品,新Mac或成焦点。接续10月1...(163 )人阅读时间:2026-10-07
12GB显存显卡跑125B模型:Strata登场
开发者 Niko1221 开源推出 Strata 引擎,使 ...(140 )人阅读时间:2026-10-07
长江存储预计NAND闪存短缺还将持续三年:AI需求继续挤压消
长江存储预计全球NAND闪存市场供应紧张将持续约三年至202...(110 )人阅读时间:2026-10-07
macOS 27.2再现关键线索 苹果触控版MacBook或
苹果最新macOS 27.2开发者测试版释放出触控MacBo...(146 )人阅读时间:2026-10-07 小米发布18 Pro系列透明特别版,采用红色主调和微米级膜片...
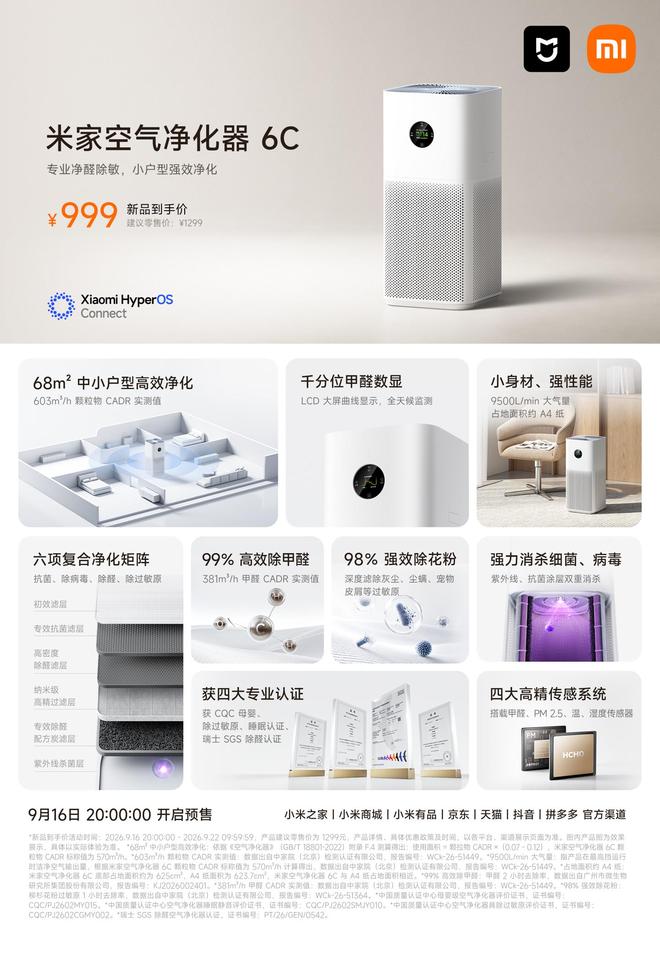 米家空气净化器6C面向中小户型设计,最大适用面积达68㎡。其...
 iQOO 15曾是不被看好的安卓旗舰黑马,销量达180万台。...
 现在的最新的iphone11充电确实比上一代的iphoneX...