大模型过去几年的能力跃迁,几乎都围绕一个词:。
模型越来越强,Agent 也开始从 “会聊天” 走向 “能干活”。
但模型部署之后呢?
一个 Agent 真正进入从没见过的软件、工具或者企业系统时,问题往往才刚刚开始。新的软件有新的交互逻辑,新的工具有新的调用方式,不同环境还有各自隐藏的约束、异常状态和失败模式。
即便底层模型已经足够聪明,它也未必真正理解这个环境里的因果结构:什么操作会带来什么结果?哪些条件会触发失败?改变哪些关键因素,才能真正把任务做成?
过去最直接的办法,是遇到一个新环境,就再收集一批交互数据,通过微调、强化学习或者人工反馈重新训练。
但这条路很难无限走下去。一方面,数据采集、标注和训练本身都要付出成本;另一方面,在企业内部软件、私人工作环境和不断变化的数字系统里,很多数据既不能公开,也不适合每换一个环境就重新训练一遍。
于是问题变成了:
如果不更新模型参数,一个 Agent 能不能像人一样,通过自己探索新环境、发现其中的因果规律、总结经验,并持续提升自己的能力?
最近,专注于因果智能的 AI 提出了 。通过 ,他们想试另一种 :不继续 Scale Model,而是 Scale 。
也就是说,模型参数先不动,让 Agent 自己进入环境探索、试错、验证,再把得到的经验不断积累下来。
给出的方案,是一套面向数字智能体的 for Self-(RSI,递归自我提升)框架:让 Agent 自己决定学什么、自己进入环境获取经验、自己验证结果,并将其中稳定的动作 — 条件 — 结果因果关系沉淀进 ,供后续任务直接复用。
这个思路延续了 AI 团队一直在追问的问题:AI 能不能不只记住 “什么通常有效”,而是真正理解 “什么改变会导致什么结果”。
更值得注意的是,这种 “靠经验继续变强” 的路线,已经在实验里表现出了相当直接的效果。
在不更新模型参数的情况下, 能够持续提升 Kimi-K3 和 GLM-5.3 等开源模型的 Agent 能力,并在 2.0 与 ’ Last Exam 上超过 GPT-6 Astra 等闭源模型。
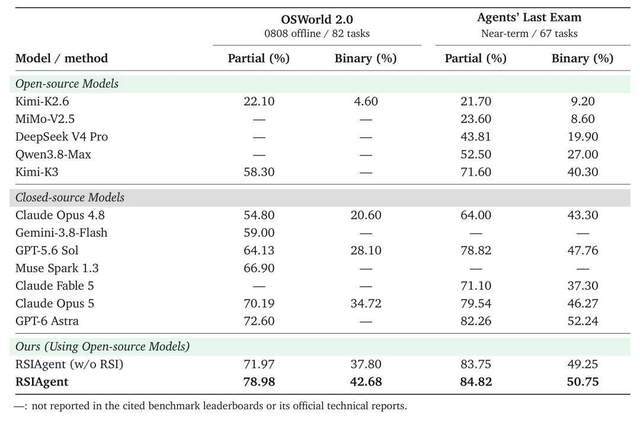
其中, 在 2.0(0808 )上取得78.98%的 Score,在 ’ Last Exam(Near-term)上达到84.82%,大幅领先于 GPT-6 Astra 的 72.60% 和 82.26%。
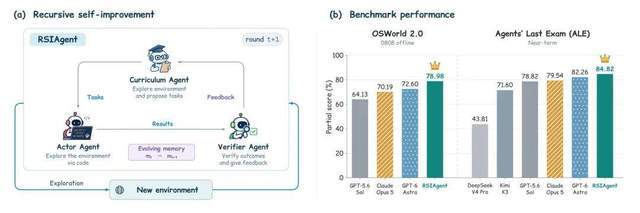
图 1| 框架与性能表现: 通过 “课程生成 — 执行 — 验证 — 记忆演化” 的递归闭环自主适应新环境,并使开源模型在 2.0 和 ’ Last Exam 上超过多款前沿闭源模型。
从 “被动学习” 到 “主动探索”: 的核心思路
的核心,是把 Agent 与新环境的交互过程本身变成一种持续学习过程。系统围绕一个不断演化的 ,构建由 agent、actor agent 和 agent 组成的多智能体递归闭环: agent 决定下一步应该探索什么,actor agent 进入环境执行任务并积累经验, agent 根据真实环境反馈判断结果是否可靠,最终将有效知识持续写入 。这样,Agent 不再只是被动完成任务,而是能够自主选择学习方向、获取经验并不断扩展自己的环境知识。
在此基础上, 进一步采用Broad-to-Deep的两阶段自探索策略,其思路类似于大模型训练中的Pre- → Post-:先通过广泛探索建立整体能力覆盖,再围绕关键难点进行针对性强化。
第一阶段:Broad Self-
这一阶段类似于Pre-,重点是从 “单点解决任务” 转向 “快速建立对环境的广泛认知”。 agent 会在每一轮同时生成多个方向不同的探索任务,例如尝试不同工具、交互方式和输入条件;随后由多组 actor agent 和 agent 并行执行与验证,再将有效经验汇总进共享 。基于当前已获得的知识, agent 会继续生成下一批更有价值、覆盖新方向的任务。整个过程形成一个并行递归链:
多方向任务 → 并行执行 → 并行验证 → 汇总更新 → 新一轮多方向任务
通过不断扩展探索方向,Broad Self- 能够快速覆盖环境中的常见规则、操作流程和失败模式,让系统先形成一张较完整的 “环境知识地图”,为后续针对关键难点的深入探索打下基础。
第二阶段:Deep Self-
这一阶段更接近Post-,重点从 “覆盖更多知识” 转向 “攻克关键难点”,主动寻找那些:难、隐蔽、容易出错、只有在复杂情况下才会暴露的问题。 agent 会首先生成一个相对困难的任务,刻意让系统进入可能出现异常、隐藏约束或边界情况的场景。actor agent 使用当前 完成任务; agent 检查结果;然后 agent 根据暴露出的失败、未知问题和脆弱环节,再继续设计一个更难的任务。整个过程变成一个顺序递归链:
困难任务 → 执行 → 验证 → 更新 → 更困难任务
每一轮都建立在上一轮刚刚获得的知识之上。因此,Deep Self- 更像是一种自动化的 “极限测试”,它不断把 Agent 推向知识边界,让系统真正知道:“这个环境在哪些地方最容易出问题。”
最终,两阶段探索得到的 会被冻结,并直接用于后续任务执行,使 Agent 在不更新模型参数的情况下获得可复用的新环境能力。
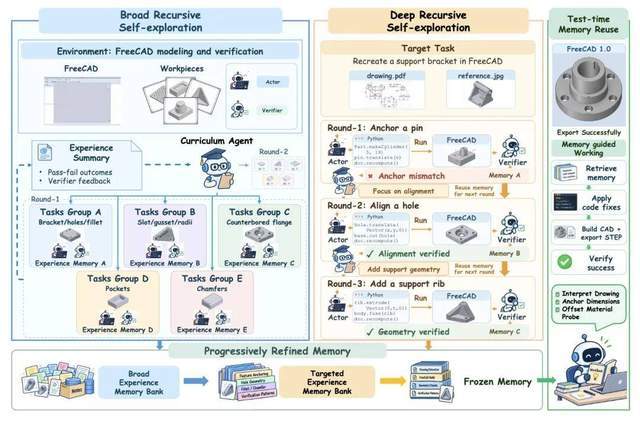
图 2| 整体框架,以 任务为例。 BRS 通过并行探索获取多样化经验,DRS 则通过逐步深入探索持续细化 。 agent 负责提出探索任务,actor agent 执行基于代码的操作并更新 , agent 负责验证执行结果。最终,累积得到的 被冻结,并直接复用于下游任务。
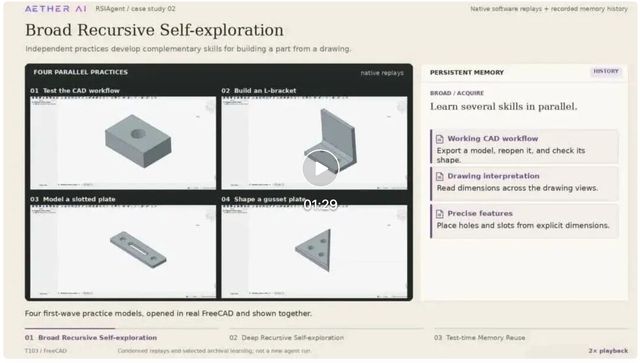
视频地址:
音频编辑与 建模任务的真实操作回放。左侧展示软件操作,右侧展示 的逐步演化与测试时复用。探索与执行过程经过加速展示。
实验分析
1. 推动开源模型超过前沿闭源模型
在 2.0 和 ’ Last Exam 上, 基于 GLM-5.3 与 Kimi-K3 这两个开源模型,其采用的 RSI 策略能够在 2.0 上面从71.97% 提升到 78.98%,大幅超过 GPT-6 Astra、 Opus 5 等前沿闭源模型。这表明,即使不更新模型参数,Agent 仍然可以通过自主探索和 演化持续突破底层模型原有的能力边界。
2. 也能泛化到 Game 等场景
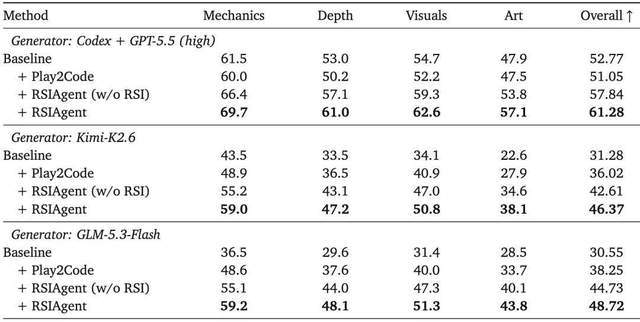
团队进一步将 应用于 -Bench 的自主游戏开发任务。结果显示, 在 、depth、、art 和 上都能带来进一步提升,说明其 “主动探索 — 自我进化” 机制能够迁移到不同类型的交互环境。
3. BRS 和 DRS 消融实验
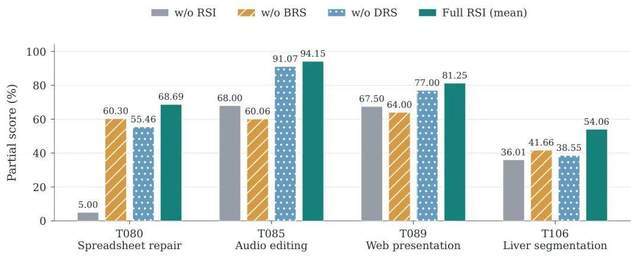
消融实验验证了 Broad Self- 和 Deep Self- 的重要性,Broad 阶段负责快速建立环境知识覆盖,Deep 阶段进一步聚焦难点、隐藏约束和边界条件,移除任何一方均会大幅影响探索的广度或深度。
4. RSI 轮次越多,Agent 呈现持续 “自我进化”
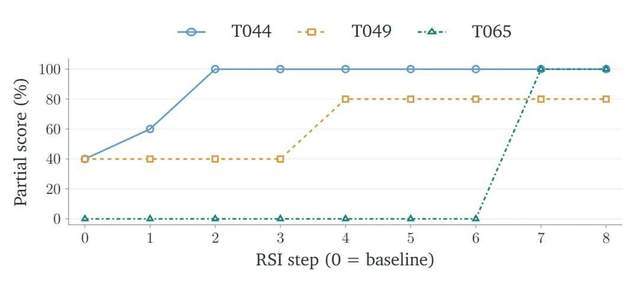
随着 RSI 轮次增加,Agent 的表现会持续提升。不同任务由于难度不同,会呈现不同的收敛速度:简单任务可能快速达到高分,而复杂任务需要更多轮探索才能逐步解决剩余瓶颈。在代表性任务中,最终得分可达到 100%,体现出类似人类探索与学习范式的递归进化过程。
背后:从 走向通用因果智能
过去几年,AI 能力提升主要依赖于 Model,但这种范式本质上仍是 “先训练、再部署”—— 模型进入新软件、新工具和新环境后,往往仍需要重新收集数据并额外训练,缺乏在部署过程中自主形成新知识的能力。
这也是 AI 因果驱动智能体路线关注的核心问题之一:AI 能否不只从历史数据中学习相关性,而是在与环境持续交互的过程中,主动识别真正影响结果的变量、理解行动与结果之间的因果结构。
围绕这一目标,团队已经从因果分析、环境探索、长期记忆到长程决策展开了一系列研究。
在 AI 看来,这些工作并不是彼此独立的 Agent 模块,而是在回答通用因果智能中的不同问题。
- 探索如何让 Agent 自主完成因果分析,从相关性之外识别真正影响结果的关键因素;C-World 构建开放式工具使用环境,让 Agent 能够在更复杂、更开放的交互过程中持续测试、收集经验与构建数据;在此基础上,Auto- 与 Self- 进一步研究如何将这些不断产生的经验沉淀为可扩展、可演化的长期记忆; 进一步将这些能力统一到长程数字智能体中,通过统一的因果结构组织状态、执行与验证。
从因果变量发现、环境干预,到记忆演化和长程决策,这些工作的共同目标,是让 AI 从 “记录发生了什么”,进一步走向 “理解什么真正导致了结果”。
可以看作这条因果驱动智能体路线在数字环境中的一次具体实践。它试图推动 Agent从被动训练走向主动因果发现与学习,并进一步迈向真正的自我进化(Self-)。面对新环境,Agent 不只是被动记录轨迹,而是主动决定 “接下来该探索什么”,通过持续交互、试探和验证,对环境施加不同干预,并观察其结果。由此,Agent 可以逐步发现动作、条件与结果之间的因果关系:什么操作会引发什么变化,什么条件会导致失败,以及改变哪些关键因素能够改变最终结果。
这构成了另一条 路径: 。在模型参数保持不变的情况下, 通过一轮轮 RSI 持续扩展探索范围,从成功、失败和边界案例中发现新的因果规律与环境机制,并将其沉淀到 中。 因此不再只是历史经验的存储,而逐步成为对环境因果结构( )的可复用认知,并进一步支撑后续决策与持续自我进化。
不同难度的任务也呈现出不同的 “进化速度”:简单任务可能经过少量 RSI 轮次快速收敛,而复杂任务需要更多轮主动探索,才能逐步发现隐藏变量、未知约束和 cases。实验中,一些初始成功率仅为 0–40% 的任务,随着 RSI 轮次增加,最终可以提升至 100%。
这意味着,未来 Agent 的能力上限不仅取决于 “底层模型有多强”,更取决于它能否通过主动干预环境,持续完成因果发现、因果验证与因果知识积累,并将这些规律转化为长期可复用的能力。
而从 AI 更大的技术路线来看, 所处理的数字环境,只是通用因果智能的一种载体。无论是数字智能体在软件中调用工具,还是机器人在物理世界中抓取、推动和操作物体,本质上都涉及同一个问题:一次行动如何改变环境,而这些变化又由哪些真正的因果机制决定。
AI 希望沿着这条路线继续推进,让 AI 不只记住 “发生了什么”,也不只预测 “接下来可能发生什么”,而是进一步理解 “为什么会发生,以及怎样改变原因,才能改变结果”。
:
: for Self- in New
Sibo Zhu†, Fan†, Wang†, Wenyi Wu, Kun Zhou*, Biwei Huang, 2026.
-: An Agent
Wang†, Kun Zhou†, Wenyi Wu†, Har Singh, Fang Nan, Jin, Aryan , , Hou Zhu, Singh, , Qian Shen, Biwei Huang. 2025
C-World: A Use Agent
Xi†, Liang†, Qi Liu, Zhang, Peng, Fang Nan, Nayim, Zhang, , Qin, Biwei Huang, Kun Zhou*. 2026
Auto- for GUI Agent
Wenyi Wu, Kun Zhou*, Yuan, Yu, Wang, Hu, Biwei Huang. 2025
Self- for GUI
Sibo Zhu†, Wenyi Wu†, Kun Zhou*, Wang, Biwei Huang. 2026
: Long- with
Wenyi Wu, Sibo Zhu, Kun Zhou*, Salvi, Song, Biwei Huang. 2026
OpenAI押注RSI,国产AI火速交卷!Flash叫板万亿
AI领域掀起自动化研发热潮,OpenAI和Anthropic...(116 )人阅读时间:2026-09-15
在多项高难度Benchmark超越GPT-6 Astra,R
大模型能力提升主要依靠 Scaling,但部署后Agent在...(77 )人阅读时间:2026-09-15
三巨头齐踩刹车,AI扩张会减速吗
美国AI实验室开始讨论“踩刹车”。Anthropic前员工发...(134 )人阅读时间:2026-09-15
从Chat、Code到Discovery,AI开始学着做科学
新公司Discovery Loop估值迅速飙升至500亿美元...(181 )人阅读时间:2026-09-15 游戏为AI提供复杂环境,推动其演进,而AI则通过生成式技术重...
 小鹏宣布其机器人生产线正式启用,首位高阶通用人形机器人完成自...
 现代云管理栈融合了多种工具和AI智能体,但存在会话隔离、并发...
 Anthropic 的 Sonnet 5.5 模型(代号 F...