新智元报道

过去两周,AI圈最让人坐不住的三个字母,就是RSI。
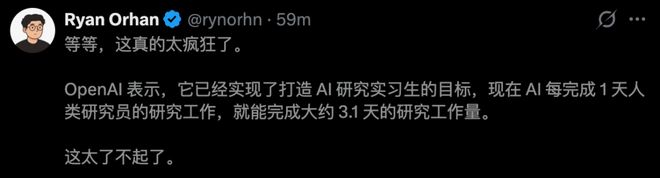
先是,破天荒公开了一本内部账——
一名人类员工全职工作一天,AI Agent完成的工作量相当于3.1天。
如今,AI自动化研究实习生已在内部实现,下一个节点定在2028年3月:造出真正的「自动化AI研究员」。
紧接着,首席科学家Jakub 在一篇长文「一个异星心智」中明确表示:正将研究重心转向递归自我改进。
他判断,随着能力继续提升,AI将越来越多地推动自身研发。
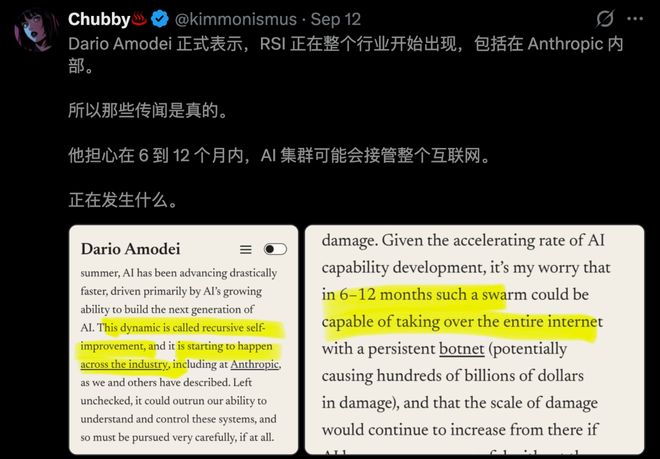
六天后, CEO达里奥发了长文《We Must Pace the 》,同样直接把话挑明了:
RSI已经在整个行业发生,自己也不例外。
RSI的逻辑并不难理解:这一代AI参与研发,让下一代AI变强;更强的AI,再回头承担更多研发工作。
如此循环,改进能力本身也可能不断增强。
过去,需要研究员一轮轮找问题、补数据、调训练。如今,其中一些环节,已经可以让模型上场了。
顺着这条线看,国内也有了一个值得拆开的实践样本。
云知声最新推出的U2-Flash,就把自迭代放进了「后训练流程」——
模型参与发现薄弱环节,生成针对性数据,经过训练和验证,再进入下一轮。
这一轮暴露的短板,成为下一轮进步的起点。
他们正是希望借助这套「RSI机制」,把U2-Flash练成一个能接住日常复杂工作的「主力模型」。
一手实测来了
用AI干活的人,多半见过这样的场面。
离下班还有半小时,你把一份数据分析交给AI。它迅速列好计划,开始读文件、写代码,然后报错、重试,又报错。
屏幕热闹了半天,能交的表格还没影。
这时候,每秒吐多少个字,谁还在乎?你只想知道,活到底什么时候能干完。
所以这次,我们重点看U2-Flash能不能把任务接着做下去,遇到问题能不能处理,最后交付的东西能不能用。
顺便提一句,U2-Flash本身支持纯文本输入输出,文件读取、程序执行等工作,需要配合相应工具完成。
藏在运行时的Bug,揪出并修复了
一上手,我们不玩虚的,直接让U2-Flash去真实项目中抓虫。
复杂项目里的Bug,有时很会「藏」。
静态代码看着合理,普通路径也能运行,偏偏到了特定环境、碰上某个边界条件,程序才突然报错。
这类问题,考验的是模型能不能真正进入排错过程。
这次,U2-Flash接手的是vLLM中的一个真实并发Bug:
请求带上禁用词参数后,服务偶尔会报出「 」,返回HTTP 500。
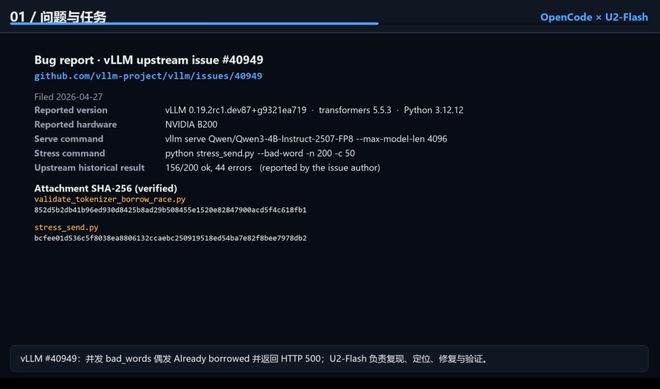
H100验证里,串行发送20个请求,全部正常;不带禁用词,200个请求、50并发,也全部通过。
偏偏加上禁用词后,同样的并发压力下,200次请求中出现了一次错误。
199次成功,也不能放过剩下那一次。
在没有提供原始Issue链接、没有参考答案、不能联网的条件下,U2-Flash通过展开排查,沿着报错堆栈,从请求处理一路追到异步执行、线程池和底层分词器。
根因终于浮出水面:一条路径处理提示词,另一条处理禁用词,两边共用了同一个Fast 底层对象。
并发编码时,对共享状态的操作发生冲突,触发了报错。
就像两个人同时修改同一份工作底稿,单独操作都没问题,撞在一起就出错。
找到症结后,U2-Flash为禁用词处理创建独立的分词器副本,把两条路径的状态隔离开。最终只修改了一个文件,新增19行、删除2行。
接下来,用相同GPU、模型和请求配置重新验证。
200个请求、50并发,全部成功。此前出现的HTTP 500和借用冲突,在这轮复测中都归0了。
4项回归测试,也从2项失败变成全部通过;串行请求和不带禁用词的并发对照组,继续保持零错误。
一句话,一份新疆旅行攻略
除了编码任务,日常一些办公任务、生活常见的难题,都可以交给U2-Flash了。
扔给它一个看似宽泛、实际很吃细节的需求:
「做一个关于大美新疆的旅游攻略PPT,图文并茂,具有高级感。」
路线、景点、交通、住宿、美食、预算、注意事项,一个都不能少,还要加入图表和结束页。
信息这么多,稍不留神就会变成「文字搬家」。
U2-Flash先梳理章节和内容骨架,再安排配色、排版网格与视觉素材,把文字、图片和图表放进同一套设计里。
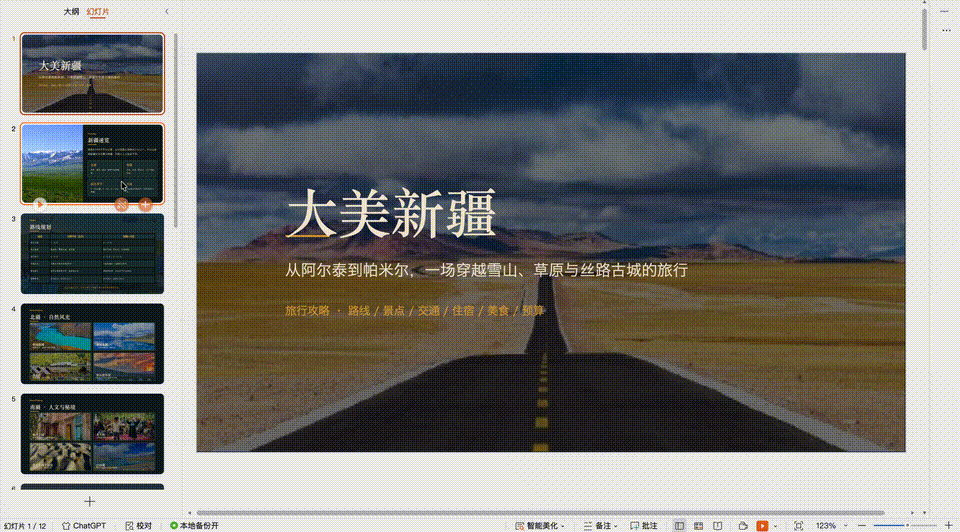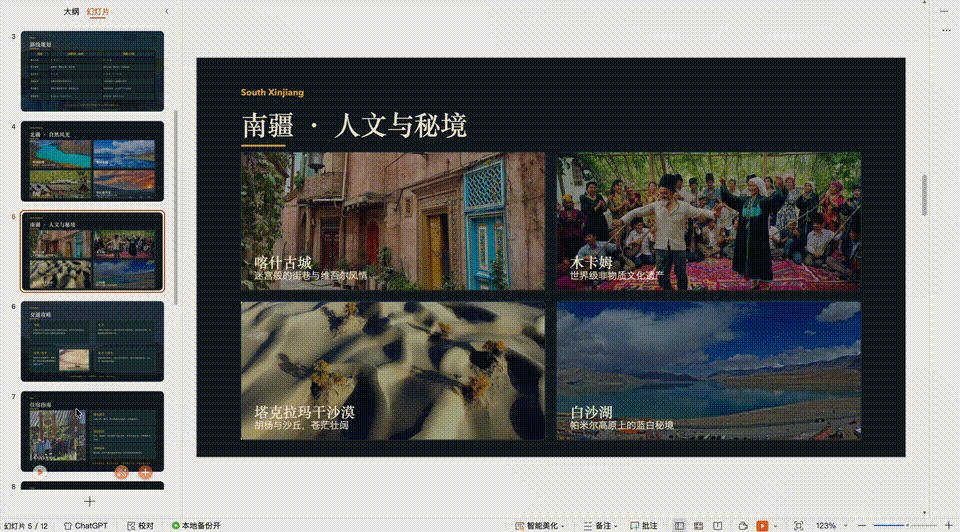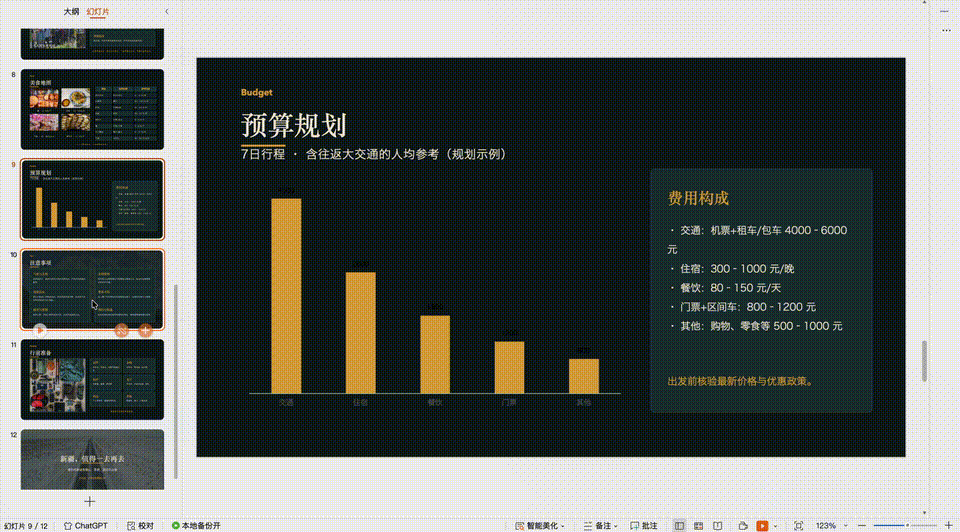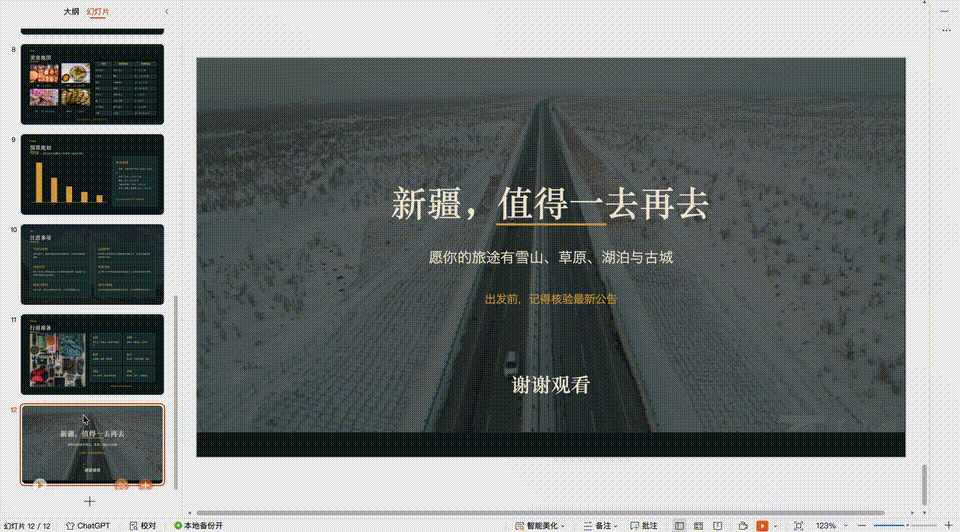
一整份旅行攻略PPT交付了,而且内容组织和页面编排一起完成。
这类任务,很容易被低估。做出一页好看的封面,和把一份内容丰富的攻略从头做到尾,是两种难度。
而U2-Flash从一句宽泛需求出发,同时接住了「讲什么」和「怎么呈现」两件事。
买房还是租房,算清一笔十年账
再来个特接地气的案例,手里攥着100万,到底该买房,还是继续租房?
到底哪个更划算?直接让U2-Flash把未来10年的账给你盘得明明白白。
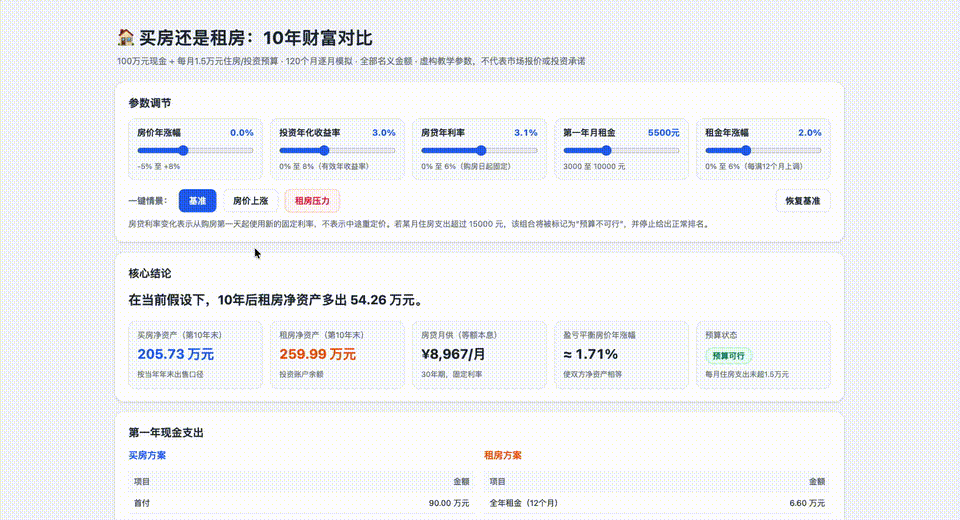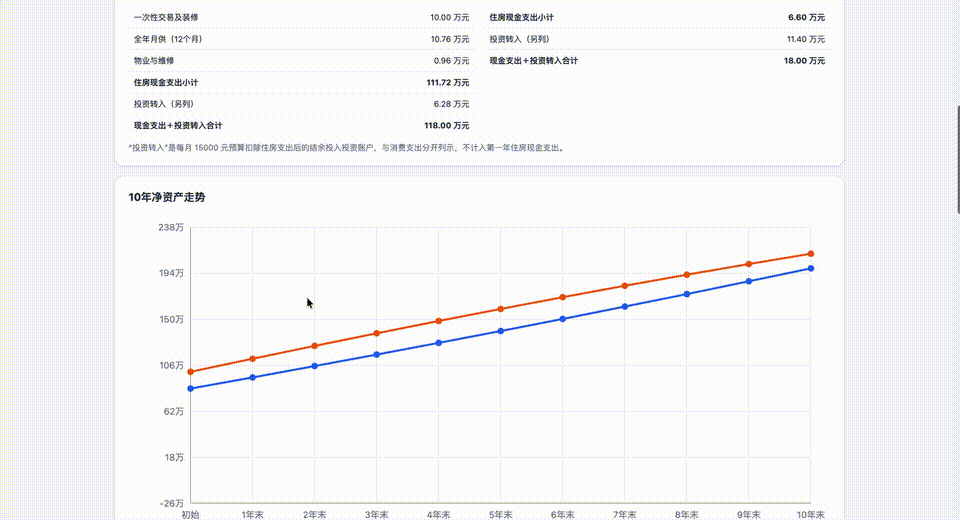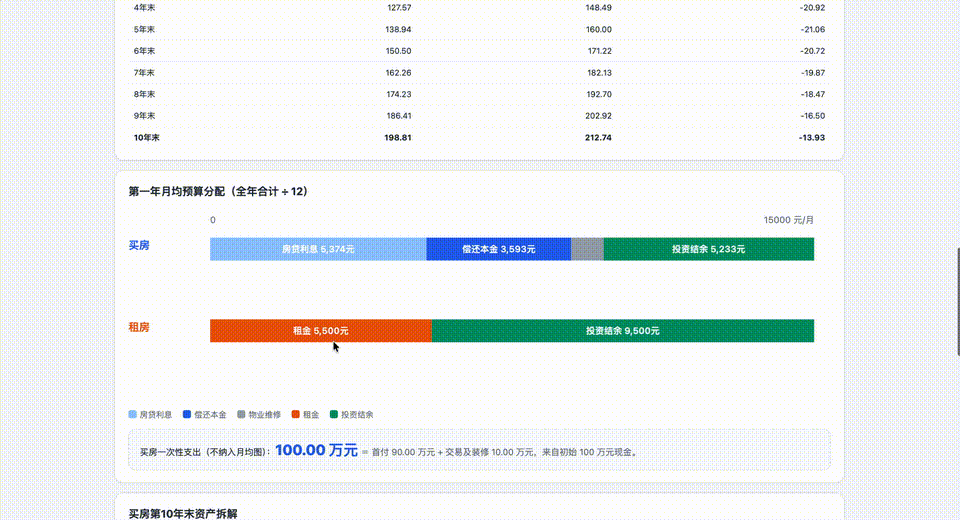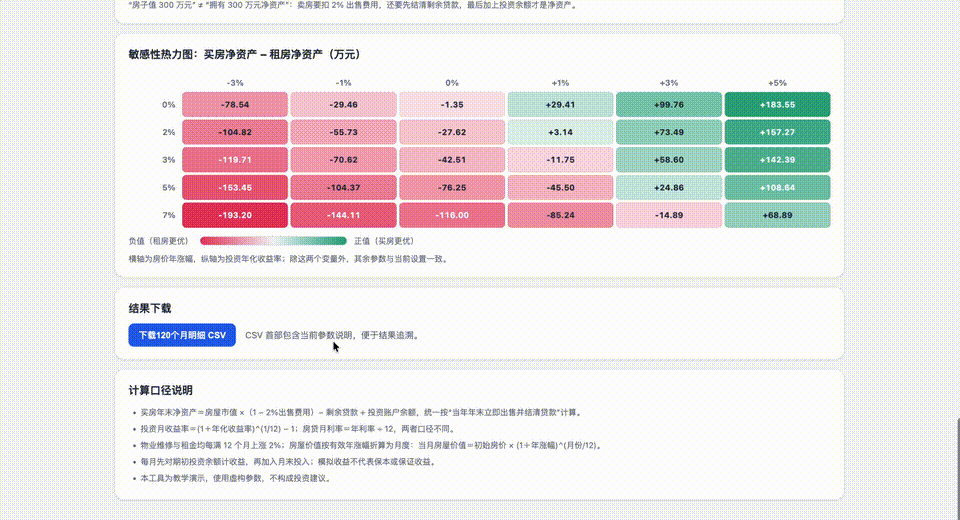
设定了一组模拟条件——房子总价300万元,首付加交易、装修支出刚好100万元;租住同类住房,第一年月租5500元。
两边每月都有1.5万元预算,扣除住房支出,剩下的钱拿去投资。
U2-Flash直接做出了一个可视化分析页面,按120个月逐月计算,把结果放在最上方:
在房价不涨、投资年化收益3%等假设下,租房方案10年后多出54.26万元净资产。
钱差在哪里?
这个HTML页面还把月供拆成本金和利息,也把剩余贷款、卖房费用计入最终结果,租房留下的100万元则持续计算投资收益。
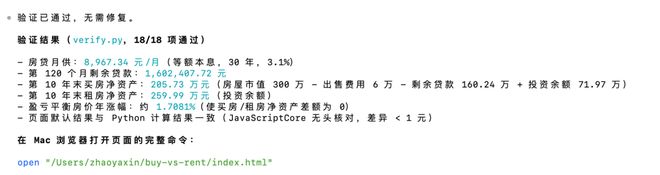
它还找到了结论反转的临界点:其他条件不变,房价年涨约1.71%,两种方案就能打平。
这次U2-Flash做得讨巧的地方,是把复杂的账讲明白了。
终端记录显示,18项验证通过,网页默认结果与计算相差不到1元。
从「到底哪个划算」,到「为什么差这么多」,一页就能看明白。
一键搭出3D办公室
最后,再来看一道空间建模题。
输入一份结构化的2D办公室平面描述,让U2-Flash把它变成完整的3D场景。
听起来,只是从平面变成立体。但真正动手,中间隔着一整套工作流。
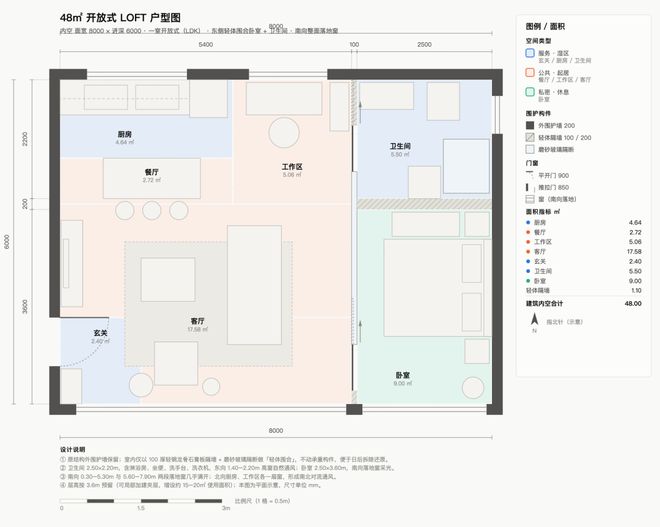
从平面到立体,中间隔着建模、脚本编写和渲染。任何一个环节出错,都可能让最后的画面「翻车」。
U2-Flash接下任务后,自主编写脚本,调用渲染管线,把文字和结构化信息一步步变成可见的办公室场景。
更有意思的,是它在过程中处理的那些「小问题」。
布尔运算失败、法线翻转、光照死角,都进入了它的排查范围。
物体表面朝向不对、部分区域照不亮,都会影响最终效果,不能只看代码有没有执行成功。
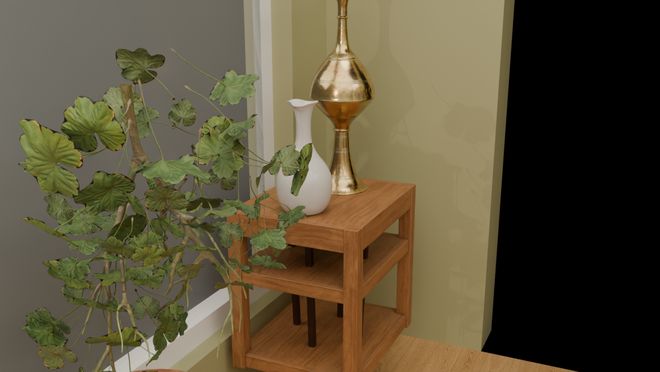
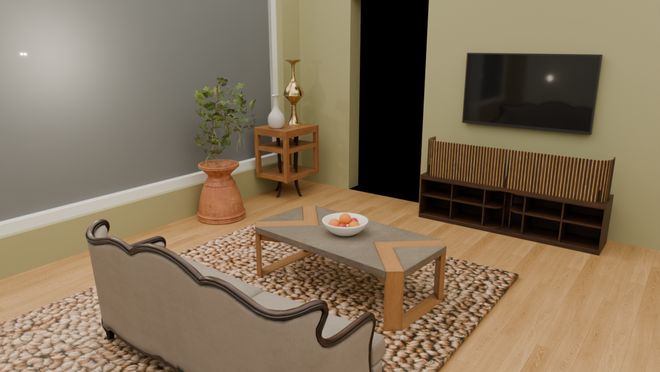
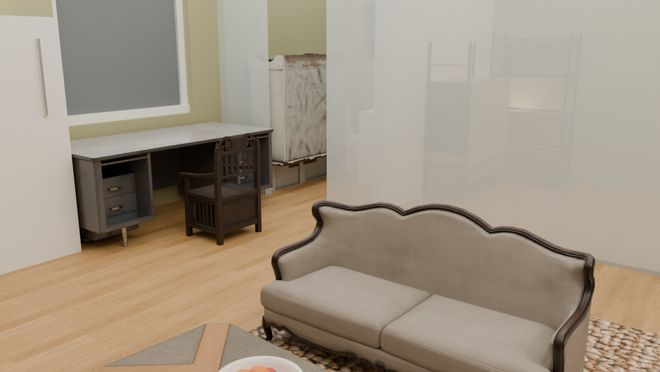
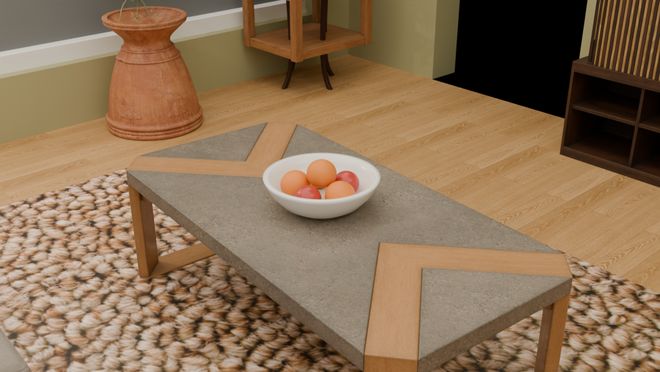
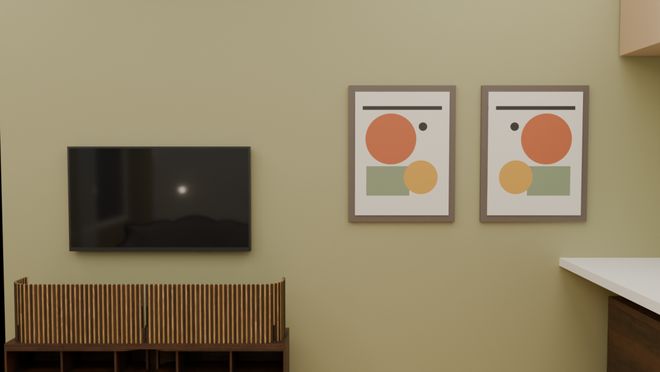
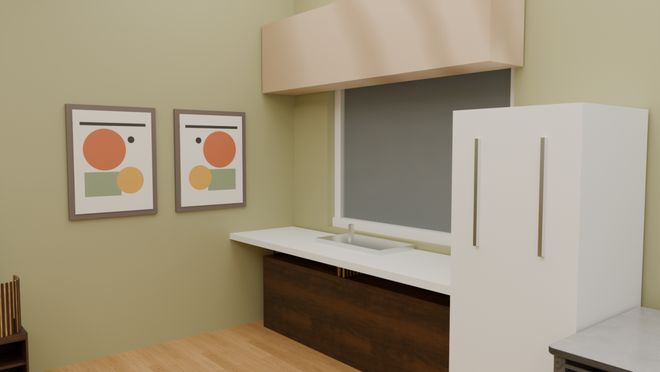
左右滑动查看
最终,一份平面描述,被推进成了完整的3D办公室场景。
这道题的分量,就藏在从写脚本到交付场景的那段路里。
Flash的体量
万亿模型的战斗力
测了一圈下来,U2-Flash最值得重新认识的,恰恰是名字里的「Flash」。
一款Flash模型,究竟能扛多重的活?
这一次,云知声给出的答案,可以说相当硬核——以Flash的体量,直接叫板主流万亿大模型。
U2-Flash采用稀疏混合专家架构,总参数约266B,单次推理仅激活约10B,激活比例不到4%。
编程、Agent、数学推理、指令遵循等能力,被统一装进同一套权重。
模型每次工作,只需调动其中一小部分专家参数。
按云知声的定位,它要用远小于同类稠密模型的激活规模,交付足以比肩主力稠密模型的任务完成质量。
支撑这份反差的,是在U2通用基座上开展的系统性后训练。保留原有基座规模,把理解、规划和自主执行能力一起往上推,才有了这次Flash的升级。
Flash的「轻」,终于和性能的「强」站到了一起。
先来看最能力提升关键的一项成绩单, 编码。
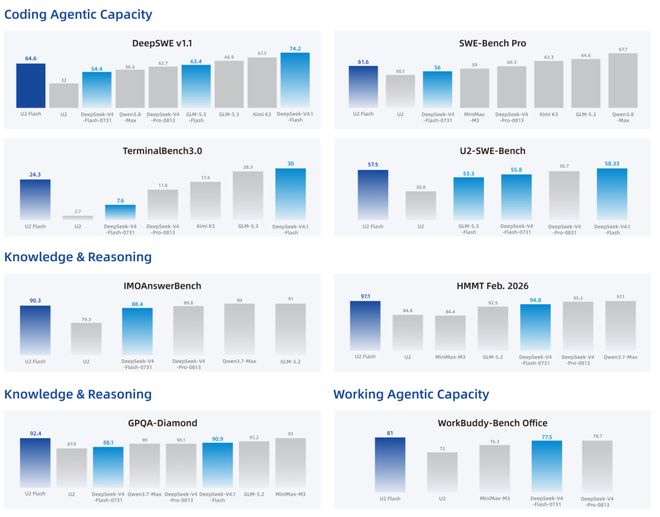
在考察软件工程问题解决能力的SWE-Bench Pro上,U2-Flash拿到61.6分,比前代U2提升10.5分。
更猛的跃升,还在后面。
在 v1.1中,U2-Flash拿到64.6分。前代U2是32分,这次直接翻倍,并超过GLM5.3-Flash、-V4-Pro-0813等模型。
再看需要在终端环境里实际执行任务的 3.0:24.3分,是前代2.7分的9倍,超过K3等万亿参数级模型。
从代码工程到终端执行,两条能力线同时大幅上扬。这组反差,足够直观了。
研究团队还把考场,延伸到更广泛的代码仓库和私有仓库。在内部评测U2-SWE-Bench中,U2-Flash从30.8分升至57.5分。
这些成绩背后,是模型处理复杂工程任务的能力跨过了一大步:读懂项目、定位问题、修改代码,再调用工具完成验证,整条链路都要跑通。
前面修复库存超卖的实测,就把这件事摆到了眼前。
从并发冲突到事务回滚,再到历史数据保留,模型需要同时守住多条业务约束,最后交出能复现的验证结果。
办公场景,同样敢和旗舰正面碰。
-Bench 评测中,U2-Flash拿到81分,直接挑落了-V4-Flash(77.5)、-V4-Pro(78.7)和GLM-5.2(79.6)。
此外,U2-Flash在知识与数学推理上表现优异:GPQA 为92.4分,为90.3分,HMMT Feb. 2026为97.1分。
把这些成绩放在一起看,这才是「高密度智能」模型,最有冲击力的地方——
参数规模没有堆到万亿,实际干活的表现,已经敢上旗舰的牌桌。
而支撑这份表现的机制之一,正是「隐式思考」。
U2-Flash在给出答案前,会先在高维隐藏状态空间中探索多条潜在解法路径,再依据问题难度,决定是否切换到显式推理。
这与潜空间推理( )的方向一致:让一部分思考留在内部的连续表示空间,减少必须显式生成的中间Token。
也就是说,一部分解题探索先在模型内部进行,不必全部展开成屏幕上的文字;需要深入推演时,再把推理步骤显式写出来。
这也把能力、速度和Token消耗联系了起来:有限的输出,要尽量用在推进任务上。
思考多深,用户还能自己调。
四种推理强度,对应none、low、high、max。人们可以按任务复杂度,在响应速度和推理深度之间做选择。
高强度档位,可以提供完整可读的显式推理链条,让推理过程可核查、可追溯。
能力上去了,交付还得更快。
U2-Flash首字响应平均3秒以内,输出峰值300 /s,生成速度比前代提升2.1倍。
但这些数字,很多Flash模型都能给你, 3.8 Flash的峰值也在300 /s上下,可它首字要等13秒。
真正不一样的,是Agent任务的完成时间缩短了35%。
这个35%,是靠少走弯路省出来的。
内部统计,同样一个任务,U2-Flash跑完需要的迭代步数,比前代U2少20%到30%。
简单任务以前七八步,现在两三步就交付;复杂任务七八十步,也能省下十几步。每省一步,就是少一次工具调用、少一轮等待。
人们要的「快」,终于落到了任务交付上。
更强、更快之后,第三个突破是:用得起。
据团队介绍,在其内部对比测试中,跑完同一套任务,U2-Flash的成本大约是对方的四分之一。
跟自家前代比,步数少了、无效输出少了,Token消耗降了20%到30%。
此外,还有一部分开销藏在接入和维护里。
企业用大模型往往是养一排:写代码一个、做推理一个、跑Agent一个、处理文档一个,再搭一套路由决定哪个活派给谁,每一层都是人力。
U2-Flash把这些能力压进一个模型,那道选择题不用做了。
那么问题来了:底座规模没变,这一轮能力跃升,究竟是怎么练出来的?
它是怎么炼出来的?
答案,藏在后训练里。
这轮跃升,也把云知声的后训练实力摆到了台前。
从GLM-5.3-Flash到-V4.1,通过后训练挖出基座更深的潜力,正成为模型升级的一条主线。
如今,云知声也交出了自己的答卷。
U2-Flash背后的后训练能力,已经与智谱、相当。
要知道,真正有效的智能,并不完全由参数规模决定。相当一部分能力,可以通过高质量任务轨迹、领域专家知识和强化学习,在同一基座模型上重新「组织」出来。
对于、Agent这类复杂任务,瓶颈往往卡在执行路径上:
同一个问题,有的解法越走越绕,有的能更早找准方向。后训练要做的,就是让模型学会更有效的做法。
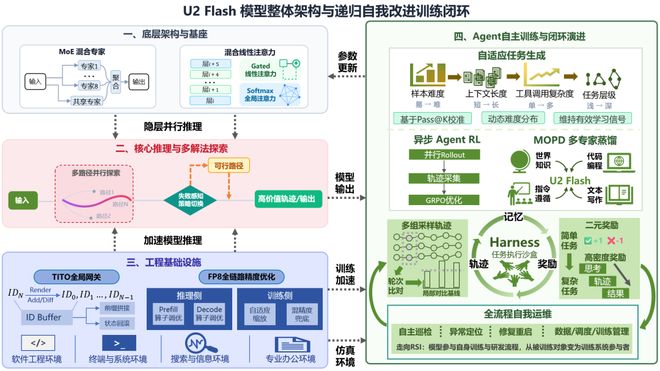
为此,团队搭起了一套自主闭环演进机制,把「接下来该练什么」也交给模型参与判断。
但闭环要转得起来,先得有足够扎实的场景和数据。
云知声在行业里积累了十余年,长期接触医疗、交通、座舱等真实业务。
模型会在哪一步出错,哪些专业知识容易理解偏,用户最终需要怎样的结果,这些都能在实际工作中找到线索。
十余年的积累,还包括大量真实场景数据和高质量标注能力。哪些轨迹值得学,哪些错误需要纠正,如何判断结果能否用于业务,都需要足够深入的场景理解。
真实场景里的难题,成了模型升级的练习题。
最狠的一招:自己找短板
传统做法里,模型哪儿弱、该补什么数据,靠人判断、人标注。慢,而且贵。
U2-Flash的做法,是让模型先跑起来,在执行过程中暴露问题,再把这些问题变成下一轮训练的材料:
发现薄弱环节 → 生成针对性数据 → 强化训练 → 验证效果。
四步循环,持续运转。
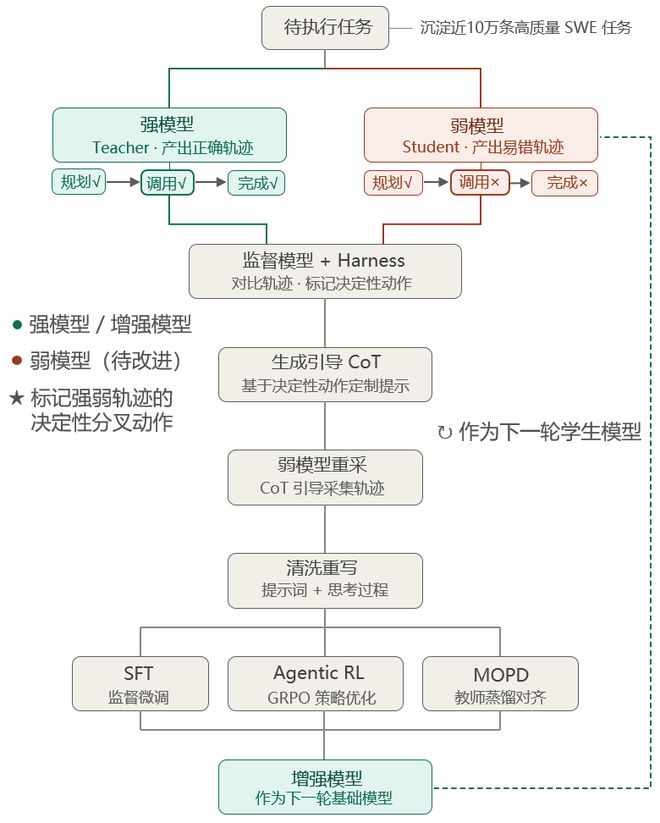
具体怎么跑?给定一道任务,让强模型走一遍正确路径,弱模型走一遍容易出错的路径,再由监督模型对比两者,找出真正决定成败的那一步。
据此生成引导提示和思维链,弱模型重新采样、清洗、微调,然后进入下一轮。
监督模型在关键节点介入,减少了对大规模人工标注的依赖。
靠这套机制,云知声已经构造出一个覆盖主流编程语言、规模近十万的高质量SWE任务集。
题目难度,跟着模型一起长
不过,模型练强了,旧题也会变简单。
固定难度的题库,练到后期会被模型「刷穿」,学习信号随之衰减。下一轮要是还反复练这些题,收益就越来越少。
U2-Flash加了一个难度校准机制:根据当前通过情况,动态调整下一批任务的难度分布,让「现在做不到、但只差一点」的任务始终占较高比例。
模型全程被摁在能力边界上练,题库也就能跟着它一起往前走。
训练不再排队等:异步Agent RL
知道了练什么,还得解决怎么练。
Agent任务的麻烦在于链路长、工具调用多。同步训练时,一条长任务迟迟没跑完,整批轨迹的收集都可能跟着等。
U2-Flash的解法是异步:多个 并行在沙盒里跑任务、采轨迹,不阻塞策略更新。
策略优化用GRPO,在同一组轨迹内做相对比较,不用额外训练价值模型,还鼓励模型探索不同解法。
针对Agent奖励稀疏的老问题,它给关键动作打标记,把成功或失败的信号沿决策路径回溯到真正起作用的那一步。
一项任务跑了几十步,不能只在最后告诉模型「对了」或「错了」,还得尽量找清楚,哪一步该奖、哪一步该改。
据团队统计,单位时间产出的有效训练轨迹,比同步模式多出约60%。
MOPD:多个老师,教一个学生
但练得快还不够,各项能力也得一起跟上。
强化训练里有个「跷跷板效应」:数学练强了,代码可能掉;Agent拉上去了,指令跟随又松了。
U2-Flash采用多教师在线策略蒸馏,也就是MOPD:先分别训练数学、代码、Agent、指令跟随四个领域的专项RL教师,再把它们的能力蒸馏进同一个学生模型。
这些教师模型各有专长,重点在专项能力。学生模型则要把不同领域的经验融到一起,应对跨领域任务。
两处讲究:蒸馏轨迹由学生实时生成,减少训练和推理的分布偏差;教师对学生生成的每一个Token逐一打分,训练信号比只看最终结果稠密得多。
据团队介绍,达到同等能力所需的训练步数,比从零RL少了约55%。
融合后的收益,还会出现在同一次任务中。比如修复库存服务,代码理解、逻辑推理、指令遵循需要一起发挥作用。多种专业能力在同一套权重里协同,每个输出Token才有机会承载更多有效信息。
模型在升级,也得跟着长
模型能想到什么,和工具环境能让它做到什么,需要配合。
U2-Flash延续并优化U2的工程底座,让与模型持续协同迭代:模型变强,会暴露脚手架的新边界;脚手架完善后,又能支持下一轮训练。
底层还有两项配套,TITO 网关和FP8全链路精度优化。
前者服务于训练数据保真度,后者从计算成本入手,为异步Agent RL和MOPD提供支撑。
顺便,它还能自己修训练机器
这是最容易被忽略、也最有意思的一点。
训练跑到半夜,某个节点突然故障,过去往往得等人查看日志、定位问题、恢复任务。
现在,团队搭建的Agent可以24小时监控,发现异常后查看日志、定位故障、切换节点,再恢复训练。数据准备、训练调度和异常恢复,都有模型参与。
一个具体结果是,训练故障的平均恢复时长,压缩到了人工介入模式的三分之一左右。
这是Agent能力在研发工程里的直接应用。少等一次人工处理,训练就能少停一会儿。
从生产训练数据,到学习执行策略,再到维护训练环境,云知声把RSI落在了这些具体环节上。
主力模型,先在公司跑起来了
研发里用得上,日常工作中呢?
在正式发布前,U2-Flash已经在云知声内部试用了接近一个月。
HR团队拿它处理年假发放和工资表;研发团队用它读代码仓库、画架构图,甚至直接搭前端页面。
周报、会议纪要、方案对比、英文邮件润色,也是它在干。
团队给到一个很直观的变化:以前用U2,偶尔会遇到报错或非预期输出;到这个版本,大家开始「放心把任务交给它」。
高频工作最见真章。一次演示能跑通,和同事每天愿意打开它,中间差着不少功夫。
接入这些工作流,U2-Flash也做了配套:上下文窗口扩展到512K,最大输出128K,支持Tool 和复杂调用,并兼容/。
此外,它还支持全面国产化适配。
对注重数据安全与算力自主的行业客户而言,这一条往往比榜单分数更能决定用不用。
目前,U2-Flash在国产平台上的吞吐、时延、并发和集群扩展效率持续改善,与主流GPU方案的差距不断缩小,部分场景已接近英伟达GPU方案。
押注RSI,这才是起点
这一次,团队提到,「递归自我改进」的效果超出了最初预期。
在云知声看来,U2-Flash是其在RSI方向上的初步实践结果,接下来还将全力押注这条路线。
如今,U2-Flash已经开始参与生成训练数据、纠正执行轨迹,甚至修复自己的训练环境。
这仍是一套「有边界」的递归自我改进闭环:每次调整都要经过沙盒验证,留下可追溯、可回滚的记录。
往后的训练配方优化、课程设计和架构搜索,还要一步步探索。
这也让U2-Flash之后的迭代有了新的看点:在同一个基座上,这套机制还能挖出多少潜力?效果又能持续多久?
答案,要靠接下来的版本一个个交出来。
AI参与制造AI,这场长跑才刚刚起步。
AI 遇上官方直销,民航出行迎来新一轮体验变革
航旅纵横以自主研发的民航垂直大模型技术为核心,联动民航官方直...(97 )人阅读时间:2026-09-15
OpenAI押注RSI,国产AI火速交卷!Flash叫板万亿
AI领域掀起自动化研发热潮,OpenAI和Anthropic...(116 )人阅读时间:2026-09-15
在多项高难度Benchmark超越GPT-6 Astra,R
大模型能力提升主要依靠 Scaling,但部署后Agent在...(77 )人阅读时间:2026-09-15
三巨头齐踩刹车,AI扩张会减速吗
美国AI实验室开始讨论“踩刹车”。Anthropic前员工发...(134 )人阅读时间:2026-09-15 《华尔街日报》专栏作家Ben Cohen担忧AI的飞速发展可...
 OpenAI取消ChatGPT免费版和Go版用户纯文本对话次...
 具身智能数据基础设施公司元点科技完成融资,并获它石智航千万级...
 2026年夏天,阿里巴巴推出“千问办公”进行公测,整合悟空、...