一架架飞机在空中有序飞行,按时起降,看似只是飞机自己的事情,实际上,它需要持续与机场、跑道、航线以及地面资源系统协同。
这正是「塔台」存在的意义:它负责把分散的飞机和地面、空中的资源协调组织起来,让飞机根据各自的任务有序运行。而当飞机越来越多、航线越来越复杂,这种统一管控和协调也就变得越来越重要。
具身智能也同样如此。
一项具身任务,本质上是多个角色的协同:机器人和相机等现场设备、云端算力、训练与推理程序,以及连接这些角色的通信和运行环境。
而随着更多机器人投入研发与应用,这种协同的复杂度与成本更将进一步放大:设备需要一个个接入,任务需要分别部署,云端与现场需要反复配置网络,不同设备和程序出了问题,还要逐一排查设备、网络、程序。
因此,当机器人从「单机」走向更大的「机群」,具身智能也需要一座新的「塔台」—— 不只是「把设备接进来」,而是统一组织管理分散的算力、设备和执行程序,让它们围绕同一项任务协同高效运行。
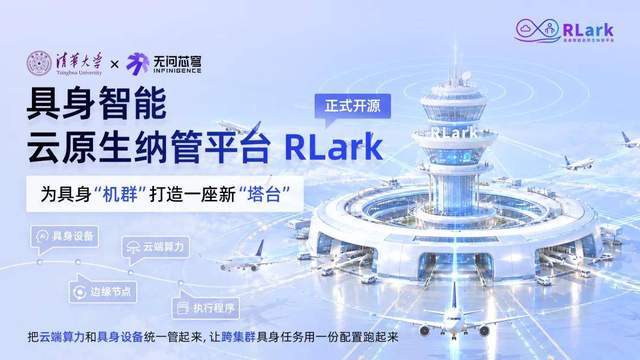
为解决这一问题,清华大学与无问芯穹共同打造并开源面向具身智能的云原生纳管平台 RLark。平台以自研的具身设备运行时(-)和任务级跨集群网络互联技术为核心,打通「真实设备如何被统一调度」与「跨地域任务如何互联运行」两个关键环节。
一方面,统一管理机器人、相机等具身设备的运行时环境,让设备可以像 GPU 一样被申请、调度和复用;另一方面,针对不同任务和网络流量特征,对跨集群通信进行任务级隔离,并优化大小包传输性能,提升云端与现场协同运行的效率。
最终,RLark 可以将云端算力、边缘节点和具身设备纳入统一资源体系,并以一项完整任务为单位组织运行。让一次实验中完成的接入、部署与通信配置,能够在后续任务中复用。运维人员通过一行命令即可接入并统一管理设备,研究人员通过一份任务配置,即可将训练、推理和真机交互程序部署到不同集群。
目前,RLark 已完成 3 个集群、近百个云边端节点的统一纳管,覆盖 4 种型号的具身设备,设备纳管从小时级缩短至约 5 分钟,任务提交后可在 10 秒内即可启动运行。同时,RLark 进一步结合训练框架,打通了跨地域的采集、训练与真机验证闭环。为具身智能实验走向更大规模的设备与更复杂的协同场景提供基础支撑。
RLark 将从用户界面、API、后端服务,到任务编排、跨集群互联和具身设备运行时的整套能力开放出来,降低具身基础设施的使用门槛,让更多团队可以直接部署和使用。
从设备接入到真机训练,一场具身智能的跨地域实测
为了验证云端算力与现场设备能否围绕同一项任务协同运行,团队将 RLark 与强化学习基础设施框架 RLinf 结合,在广东云端 GPU 集群与北京机器人现场之间,完成了一次跨地域的真机实测。
这项实验同时涉及现场机器人与相机、云端 GPU,以及训练、推理和真机交互等多个执行角色。
这次实验重点验证的,不只是「能不能把设备连起来」,而是 RLark 能否让一项原本需要多处配置、多个程序协作的复杂实验,更快准备、更简单运行,并形成完整的采集 — 训练 — 验证闭环。
视频地址:
5 分钟完成设备纳管:让云和端的资源可被统一申请
实验准备阶段,运维人员首先将云端 GPU 集群与现场设备所在集群接入 RLark,由各集群 Agent 同步节点容量、资源信息与运行状态。随后,通过具身设备运行时(-)接入已适配的双臂机器人与相机,将真实硬件注册为任务可申请、可调度的资源。
在测试环境下,具身设备纳管从传统的 1 小时骤降为 5 分钟。完成接入后,研究人员可以在平台中统一查看两地资源的位置、类型与可用情况,并在后续实验中持续申请和复用,无需每次重新接入设备。
10 秒内启动任务:用一份任务配置组织两地执行
资源准备就绪后,研究人员通过一份任务配置,定义训练、推理和真机交互等执行角色,声明各角色所需的资源、实例数量与部署位置。例如,训练角色使用云端 GPU,真机交互角色申请现场机器人与相机,共同归属于同一项具身任务。
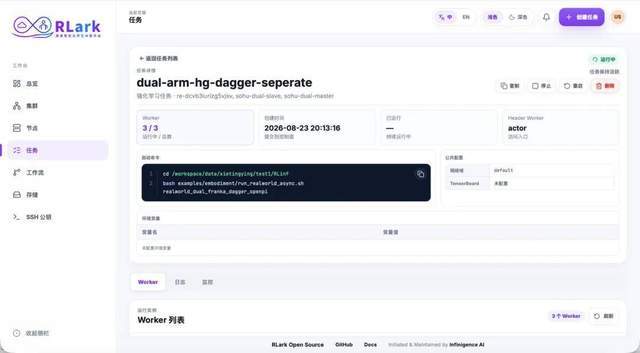
任务提交后,RLark 将配置下发至相应集群,由 Agent 创建执行实例,并建立实例之间的跨集群通信关系。
在资源已接入且具备运行条件的测试环境下,任务提交后 10 秒内即可在平台侧启动,无需逐台登录设备、分别部署程序。
全链路跑通:实现采集 — 训练 — 真机验证闭环
任务启动后,现场机器人与相机持续产生交互数据,并回传云端由 RLinf 用于训练;训练后更新的策略再用于后续真机交互,形成采集 — 训练 — 验证的持续循环。
本次实验连续运行约 36 分钟,训练推进至 323 个全局训练步骤( step),完整跑通了设备申请、跨集群调度、真机数据回传、云端训练和策略更新全链路。
运行过程中,研究人员可以从同一任务入口查看各角色的状态,并沿执行实例、节点、设备与日志定位异常。后续更换设备、调整角色规模或算法参数时,可以直接修改并复用任务配置,减少重新搭建实验流程的工作。
通过这次实验,RLark 将原本分散在不同地点的设备、算力和执行程序组织到同一项任务中,验证了云端算力与现场设备围绕同一项任务协同运行的能力,实现了从资源接入、任务启动到持续运行的一体化协同。
通信优化专项测试:跨地域真机训练更流畅
RLark 结合虚拟寻址、 用户态网络栈与 SSH 安全隧道,为分布在云端和现场的执行实例建立通信通道,由平台统一维护路由、隧道与转发关系,支撑真机数据回传与策略同步。在此基础上,通过训练框架 RLinf 的分布式通信方式,进一步优化数据流转,减少不必要的跨域传输,协同完成任务级跨集群通信优化。
为了进一步验证这条跨地域任务链路的通信能力,团队针对任务级跨集群网络互联开展了专项测试。
在受限网络环境下,RLark 的大包单流吞吐较测试所用 VPN 方案提升约 49%,小包单流吞吐提升约 14%;在高带宽环境下,大包单流吞吐接近 2 Gbps。
更高的传输效率,为模型、交互数据和运行信息在云端与现场之间持续传输提供了更稳定的通信基础。与传统的 方案对比,RLark 显著减少了跨地域真机任务运行过程中因网络传输造成的卡顿。
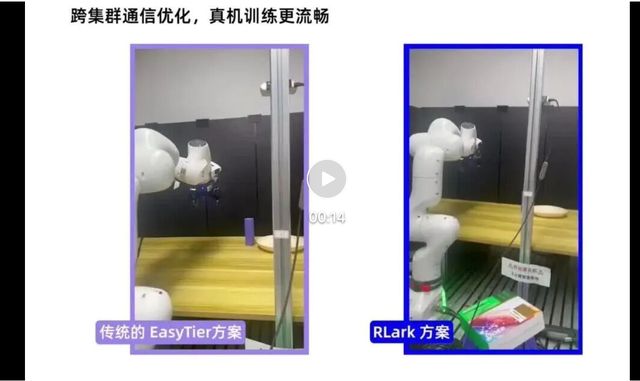
视频地址:
RLark 技术路径:贯通设备接入与任务运行
一项具身任务真正运行起来,需要解决的不只是设备接入,还包括任务怎么部署、不同集群之间怎么通信,以及运行过程中出了问题怎么定位。
RLark 采用控制面与数据面分离的架构,将分散在云端、边缘和实验现场的资源纳入统一管理。
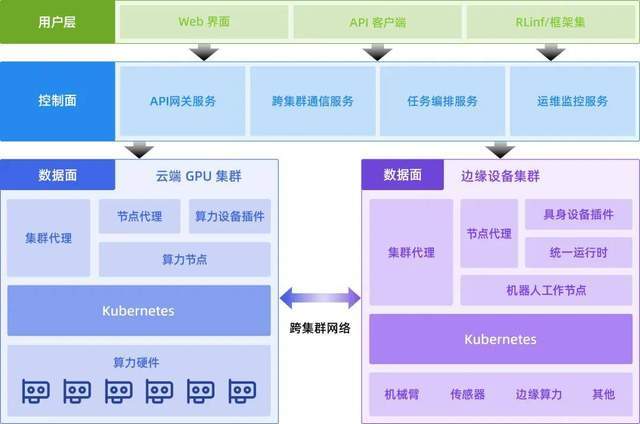
RLark 整体技术架构图
用户通过 Web 控制台、API 或命令行工具(CLI)管理资源、提交任务;控制面承担「塔台」的协调职责,统一维护资源信息、任务配置与通信关系;各集群中的 Agent 负责本地任务部署、资源同步与状态回传。
这座「塔台」主要由四项核心技术共同支撑:
自研具身设备插件与运行时:让机器人成为可管理调度的资源
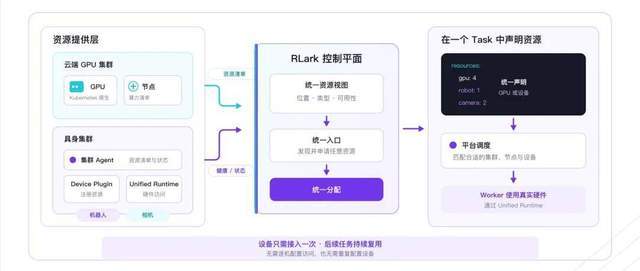
RLark 将云端算力、边缘节点与机器人、相机等具身设备纳入统一资源体系。各集群 Agent 持续向控制面同步资源信息和运行状态,用户可以从同一入口查看资源的位置、类型与可用情况。
针对具身设备,RLark 研发了具身设备运行时(-),通过统一硬件抽象,将机器人、相机等真实设备转化为云原生系统中可识别、可申请、可调度的资源,使其能够与 GPU 等算力资源共同参与任务编排。
这一过程由设备插件与运行时协同完成:设备插件发现并注册已适配的具身设备,将其资源信息提供给 ;各集群 Agent 向控制面同步资源信息与运行状态,形成覆盖云端算力、边缘节点和现场设备的统一资源视图。任务申请资源后,平台组织资源分配,运行时为执行实例提供访问所分配硬件的能力,打通从资源声明、调度分配到真实设备使用的完整链路。
研究人员因此可以在同一份任务配置中声明 GPU、机械臂和相机的类型与数量,由平台统一组织使用。机器人由需要单独连接和配置的外部设备,转变为能够与算力一起申请、分配和复用的任务资源。
任务级跨集群通信优化:让同一任务中分散的角色真正连接
RLark 研发了任务级跨集群网络互联技术,通过虚拟地址与 SSH 安全隧道,将同一任务中分布在不同集群的执行实例连接起来,为云端训练、推理与现场真机交互提供统一通信通道。在此基础上,训练框架可进一步优化任务部署与数据流转,减少不必要的跨域传输。
清华大学联合无问芯穹开源具身智能云原生纳管平台RLark,5
飞机起降需塔台统一协调,具身智能同样需要类似系统。随着机器人...(179 )人阅读时间:2026-09-24
智能终端变成token工厂,这家公司要让AI真正被深度使用
2026云栖大会聚焦端侧AI,中国AI产业重心转向终端。千问...(53 )人阅读时间:2026-09-24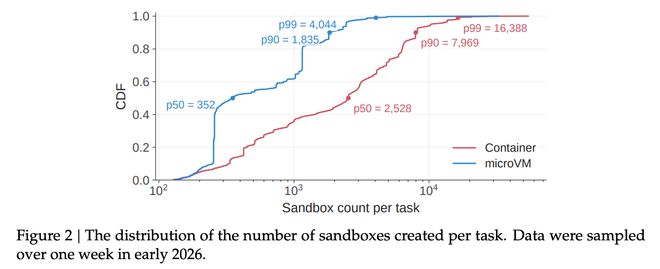
梁文锋署名,DeepSeek发新论文!剑指大规模Agent训
DSec平台为Agent训练提供大规模沙盒支持,保障稳定运行...(127 )人阅读时间:2026-09-24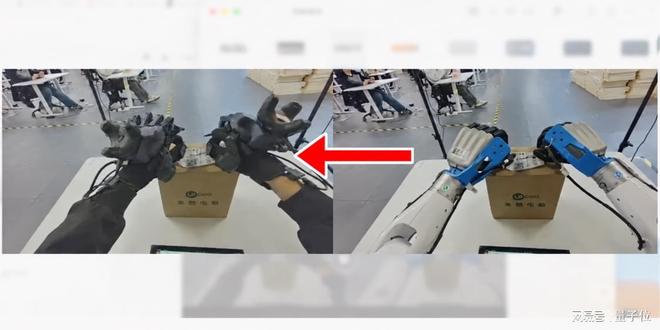
教机器人干活,光“刷课时”可不够!灵初这次较真数据质量
Psi-W0将人手示范转化为机械手可执行的操作轨迹,通过预训...(130 )人阅读时间:2026-09-24 MiniMax H3 视频模型效果显著,与 Seedance...
 内蒙古乌兰察布因“东数西算”成为AI算力版图迁移的缩影,华为...
 天智航医疗公告将于7月30日复牌,并发布《发行股份购买资产并...
 WorkBuddy发布新版本,深度打通腾讯文档,实现文件侧边...