机器之心编辑部
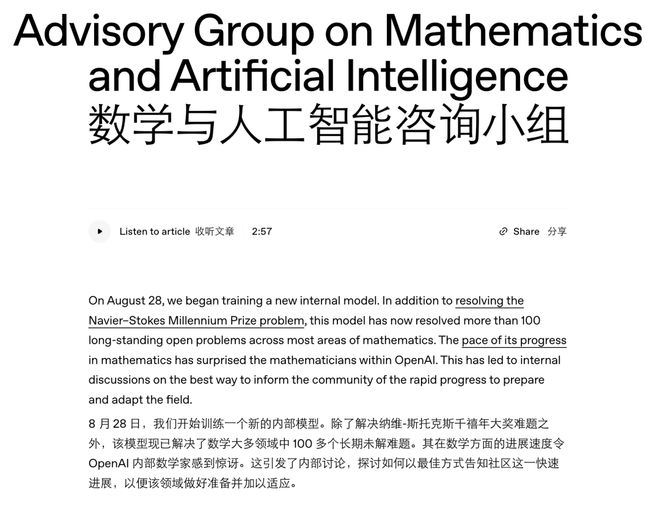
9 月 21 日, 扔出一则公告:一款 8 月 28 日才开始训练的内部模型,已经攻克了 100 多道世界级数学难题,范围横跨数学的大部分领域。
可以说,数学圈的情绪,在这半个月里一路往下沉。读博的担心学位贬值,教书的担心期刊崩盘,写了半辈子证明的人开始怀疑,这门手艺还剩几年。
就在这片低气压中间,多伦多大学数学家 Litt 在个人博客上发了一篇长文,标题叫《A for 》—— 数学的开端。
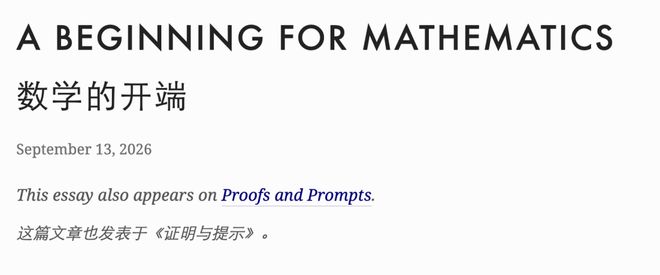
这个标题多少带点自我纠正的意味。几周前,Litt 刚做过一次名为《The End of 》的演讲,讨论 AI 可能如何冲击数学研究。新文章里,他给出了一个明显更积极的版本。
Litt 直接接受一个很激进的前提:能够在大部分数学任务上稳定超过人类的 AI,可能很快就会出现。
他真正想讨论的是,到了那一天,数学这门职业该怎么改,学生还该怎么培养,人类数学家又该把精力放在哪里
他的结论其实很乐观:AI 可以让高质量数学越来越不依赖人类亲手生产,但人类对数学的理解,反而可以变得更深。
如果一只猴子也能「证明定理」,
那我们到底在追求什么?
Litt 在文章开头先摆了一组时间线:三年前,AI 连两个数相加都经常算错;一年前, 和 的内部模型拿到了 IMO 金牌水平的成绩;现在,这些系统开始自主解决重要的公开问题。
然后他戳破了一层窗户纸:数学共同体对「我们的目标是什么」根本没有共识。
有人搞数学是为了解题,有人觉得数学是游戏、是诗;有人信奉希尔伯特那句「我们必须知道,我们终将知道」,有人觉得在勘探柏拉图世界的奥秘,还有人认为这份工作的意义在于把对数学的热爱传给下一代。这个群体其实从来没有一个统一答案。
Litt 自己把目标压缩成两条。一是生产并理解高质量的数学;二是培养高质量的数学家。这里的「高质量」并没有固定定义,它一直由数学共同体自己慢慢形成。
问题是,过去很长时间里,数学界用来实现这两个目标的办法都差不多:证明定理。论文要有主定理,博士论文要有主定理,解决一个扛住了多年猛攻的公开猜想更是头等大功。
但 Litt 认为,这个评价方式其实漏掉了关键的一层。
他举了一个很荒诞、却非常直观的例子:假设给一台计算机或一只猴子一套 ZFC 公理,再让它不断机械地应用推理规则,它其实也可以源源不断地产生定理。
猴子当然只是比喻。重点是,只要完全不在意这些定理讲了什么,只追求「逻辑上成立」,整个过程本来就不难自动化。
开放问题也可以这么干。让这只猴子把所有可能的数学命题按顺序枚举出来,再一个个尝试证明,总有一天,它也会撞上一些今天人类正在研究的问题。
这当然荒谬。但整个共同体面对「会证定理的机器」时的警惕,恰恰说明数学真正看重的,从来不只有「这个命题被证明了」。
接着他把实验升级:假设这只猴子极其聪明,理解自己证的东西,阐述写得漂亮,知道我们觉得什么有趣,顺手解决了一批悬案,还能提出更多根本性的新问题。到这一步,人类数学家还有存在的必要吗?
Litt 的答案是有。机器确实能生产我们想要的答案,但它生产不了人对答案的理解。他的判断是:我们可能正站在一次数学大爆炸的前夜。模型会产生比现在多得多的新结果,但只要我们还在意「人类到底理解了多少数学」,数学家就不会因此变得多余,甚至可能更忙
真正该保住的,
不一定是期刊、论文和今天这套制度
顺着这个判断往下,Litt 开始区分两件事:数学本身的价值,和今天学术数学的制度形态,不是一回事。
他真正希望保留下来的,是学习讨论班,是数学家之间偶然碰出来的新想法,是学生敲开老师办公室讨论一道题,也是很多人花时间一起把一个原本没人弄懂的问题慢慢想明白。
期刊、同行评审、arXiv、论文署名这些今天很重要的东西,则未必要一成不变。
Litt 甚至觉得,数学界现在有点太执着于「怎么保护旧制度」:怎么保住期刊体系,怎么防止 arXiv 被 AI 论文淹没,怎么继续维持数学家作为知识守门人的角色。
如果一个现成模型花几美元,就能产出相当不错的新数学,那么指望现在这套平衡几乎原封不动地延续下去,本身就不现实。
这里还有一个很容易掉进去的坑。既然 AI 现在还不太会搭理论、不太会提出真正好的问题,那数学家是不是应该赶紧把这些能力变成新的评价标准?
Litt 并不赞成。原因很简单:学术制度变化得太慢,模型能力升级得太快。
今天刚决定「以后重点奖励会提问题的人」,几个月后模型可能也已经很会提问题了。与其一直追着模型当前的短板跑,不如直接考虑终局:假设 AI 最后真的把绝大多数数学能力都补齐了,我们还想保留什么?
数学博士最该证明的,
也许不再是「我写出了一篇论文」
接下来,Litt 把问题转向教育。
在他看来,现在最紧迫的事情其实不是教授以后怎么研究,而是:学生还应该做什么?
过去博士论文承担了两个作用。它既贡献新的数学结果,也同时向外界发出一个信号:这个学生确实掌握了这些数学。
然而,AI 让第二个功能开始失效。一个学生现在理论上完全可以交出一篇自己都没有完整读过的博士论文。文本本身可能很漂亮,里面甚至有真正的新结果,但它已经无法可靠说明作者本人到底懂了多少。
所以 Litt 提议,把两件事分开:数学进展是数学进展,数学能力是数学能力。
未来数学博士的目标,可以重新定义成:成为某个重要而深刻问题上的真正专家,并且有能力把自己的理解传达给别人。
论文当然还可以存在,但学位是否授予,可以更多依赖一次真正严格的答辩。你得能把问题讲清楚,能应对专家不断追问,能处理陌生例子,也能把某种方法迁移到新的情况里。研究结果是不是最初由 AI 找到,反而没那么关键。
也就是说,学生完全可以用 AI,但最后必须自己懂。
这也意味着,很多看起来很传统的评价方式可能重新升值。论文越来越容易生成以后,一场报告、一次长时间讨论、一次面对面的数学追问,反而更能判断一个人到底有没有形成真正的理解。
被低估了很久的能力:
知道什么问题值得问
再往下推一步,Litt 发现数学共同体还有一项长期被低估的工作:筛选什么数学值得研究。
今天 AI 之所以能拿各种开放问题练手,是因为前面已经有一群人类数学家替它做过筛选。
某个猜想之所以会成为「开放问题」,通常意味着已经有很多人认为它有价值,也愿意围着它花几年时间。换句话说,这些问题天然带着数学共同体长期积累出来的一层背书。所以,AI 看起来是在自主解题,但它眼前很多「好题」,其实都是人类提前挑出来的。
Litt 觉得,这项能力过去得到的奖励远远不够。未来甚至可以更明确地奖励那些能搭建研究纲领的人:他提出一组好问题,构建一个值得长期推进的方向,还能说服其他研究者「这里值得挖」。
当然,他也没觉得这件事永远只能由人完成。AI 大概率也会越来越会提问题、做猜想、设计研究计划,最后很可能产出海量 PDF。
当 PDF 多到看不完,
数学真正的瓶颈开始浮现
接下来,Litt 提出了另一个问题:怎样继续生产高质量数学。
Litt 的态度其实很激进。他觉得已经没必要幻想阻止人们「按一个按钮生产数学」。你不可能让所有业余爱好者和研究人员都不用 AI,也不可能把一批题圈出来,说这些必须留给博士生手算。更重要的是,他也不觉得应该这么干。
公众现在对数学的兴趣可能比历史上任何时候都更高,这本身就是好事。真正的问题是,当大量新数学出现以后,有没有足够多的人真正理解它。
Litt 用了一个很有意思的说法:如果一个猜想倒在森林里,却没有人听见,那又有什么关系?
模型自己提出了一个漂亮猜想,再自己证明出来,如果世界上没有任何人真正理解它、关心它,那么它在纯数学里的价值其实很有限。所以数学内容越丰富,反而越需要更多数学家。
即使一些结果有直接应用,也仍然需要有人能看懂它们使用了什么假设,结论能推到哪里,在哪些情况下会失效。
数学生产力提升,并没有消灭理解成本,它只是把这个瓶颈暴露得更明显了。
数学第一次可以「氪金」了
数学以前可能是最便宜的科学,因为做数学不需要粒子对撞机,不需要湿实验室。很多时候,一个人、一块黑板就可以开始。
AI 出现以后,一部分数学问题第一次变成了可以通过「注入现金」解决的问题。多买算力,多烧 Token,多跑几轮推理,就可能拿到结果。
有些数学家对此很失落。因为过去,一个难题悬在那里,可能会把一群人聚起来。大家为了绕过它,会发展辅助理论、创造新工具,甚至意外找到比原问题更重要的东西。现在,如果模型直接把答案吐出来,中间很多「绕路」可能不会再发生。
Litt 承认,这种损失是真实的。但他的反应很干脆:如果一道基础数学问题,花一顿不错的晚餐的钱就能解决,那应该高兴。
因为答案出来以后,事情远远没有结束。接下来还得继续问:这个答案解释了什么?它让我们理解了什么?为什么会这样?还能推广到哪里?它又带来了哪些新的问题?
其中一些问题,可能再次被 AI 用一顿晚餐的钱解决;另一些问题则会重新让所有人陷入困惑,然后围绕这种困惑,新的数学共同体又长出来。
最后那一步,AI 真的没法替你走
Litt 最后把镜头拉回了一个很普通的场景。一个学生碰到一个问题,没想明白,于是去敲教授办公室的门。两个人可以问 AI,也可以不问,也许他们会先站在黑板前自己推一阵。模型后来可能给出一个非常漂亮的解释。但事情到这里仍然没有结束,因为 「看到一个解释」和「自己理解它」之间,还有一步。这一步没人能替你完成。
AI 会不会越来越强?Litt 基本默认会。AI 会不会解决大量今天看起来很困难的问题?他也认为会。很多今天的论文、博士培养、人才评价方式会不会因此过时?大概率也会。
但数学不会因此被「做完」。答案越来越容易获得以后,我们还是会追问它意味着什么;一个困惑解决之后,又会冒出更多困惑。
Litt 最后写道:还有太多东西等着我们学习 —— 无穷无尽。
所以,我们其实一直都站在数学的起点。以后也会如此。
参考链接:
GPT-6自己打开软件干活了!一张图纸长出3295个零件,一
OpenAI的Astra模型展示了惊人的3D建模能力,能根据...(150 )人阅读时间:2026-09-28
OpenAI横扫100多道世界难题,他却说:数学才刚开始
OpenAI的内部模型攻克大量数学难题引发数学界担忧。多伦多...(114 )人阅读时间:2026-09-28
答对了,理由却错了:港科大提出LexAgentHallu,追
法律大模型智能体在复杂任务中易因早期错误(如引用错误法源)导...(197 )人阅读时间:2026-09-28
AdaRoboVLG:适用于不同机械手的任务自适应视觉语言抓
AdaRoboVLG 是一个任务自适应视觉语言抓取框架,旨在...(198 )人阅读时间:2026-09-28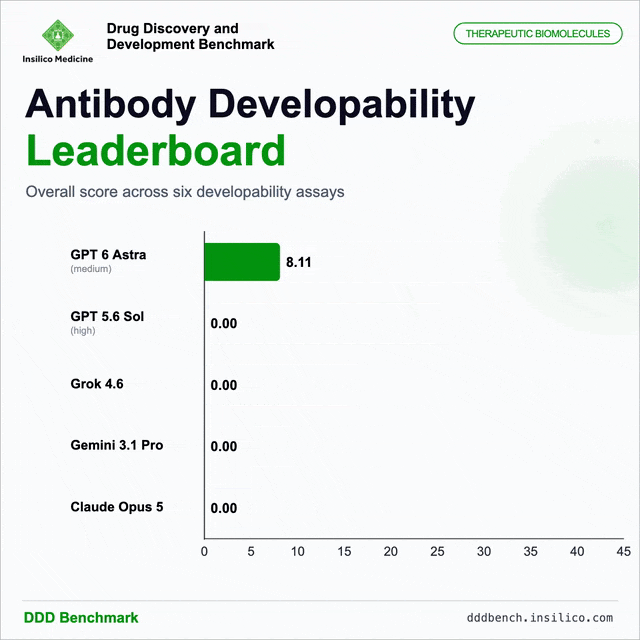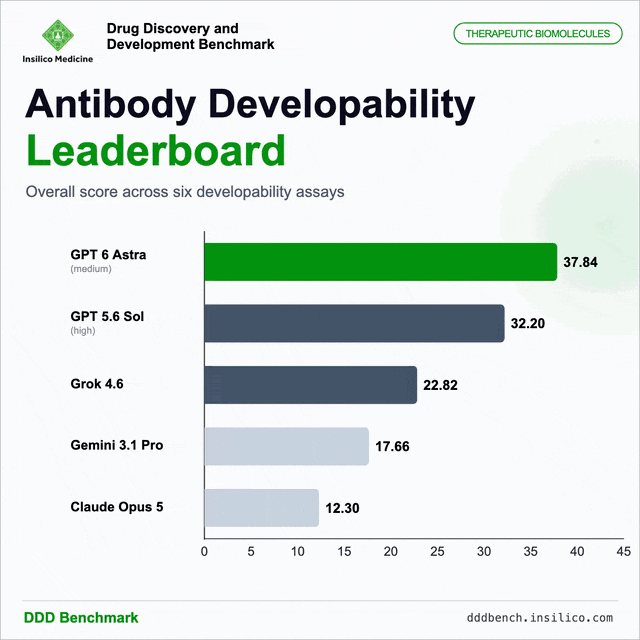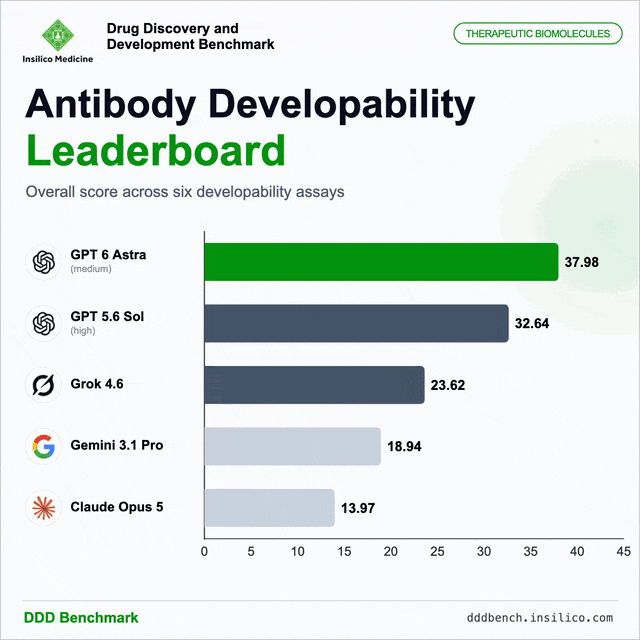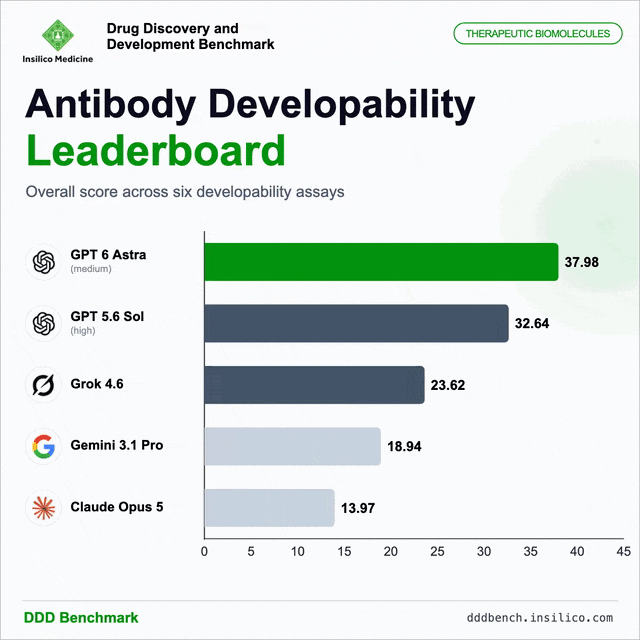 GPT-6 Astra 在 DDD Benchmark 的抗...
 宇树机器人确定发行价150.80元/股,发行后估值达610亿...
 8月7日,澳大利亚AI基础设施独角兽Firmus宣布20亿美...
 Self-Developing Agents 项目研究 AI...