核心结论:V- 将 50,248 个视觉样本拆成 352,938 条可逐项检查的准则,让图像中的事实、推理步骤和任务要求分别参与奖励计算。基于同一 SFT 起点和同一批 RL 数据, GRPO 在通用与知识评测中的 Avg. 达到 68.04。
多模态模型给出的推理过程即使连贯,也可能读错图表数字,或写入画面中不存在的物体。如果最后的答案恰好正确,按结果评分的训练方式就可能把这些“看似结果正确”但“实际推理错误”的情况也一并奖励。
反过来,最终答案错了,也不意味着此前的观察都错了。那些有依据的正确观察,仍然是有价值的训练信号:保留并强化这些观察,可以帮助模型在此基础上修正后续推断。但这也引出了一个关键问题:当正确的观察与错误的推断交织在同一段回答中, 应当如何分配,才能鼓励做对的部分,并引导模型纠正出错的环节?
来自南洋理工大学 S-Lab、A*STAR 和 UIUC 的研究团队提出了V-,用逐项评分()来处理“信用分配”( )问题。视觉事实、推理步骤和任务要求分别列为评判的准则,而这些单项的得分则会被用于后续的 GRPO 强化学习。该论文已被 EMNLP 2026 主会接收,代码与数据现已开源。
正确的观察与错误的推断
为什么要分别评价?
论文给出了一个直观例子。面对“图中有多少人出生于二战结束之后”的问题,答案级 GRPO 模型准确识别出 4 个人,却随后凭其中一名男子的外貌估计其年龄超过 70 岁,并据此断言他出生于 1945 年以前,最终回答 3 人。人数识别本身没有出错,问题出在后续的年龄与出生年份推断上。
如果只按最终答案计分,训练只能知道整道题没有答对,却得不到更具体的判断:识别出“4 人”是有图像依据的,后续推断则需要修正。对于图表、几何题或文档问答,这类混合情况同样常见,一处错误读数或不成立的推导,就可能改变最终结果。而 V- 将人数识别、出生年份推断和最终作答分别列为检查项,训练时再使用这些逐项判断。
把视觉证据写进奖励
围绕一条视觉回答的形成过程,V- 将准则分为三个维度:
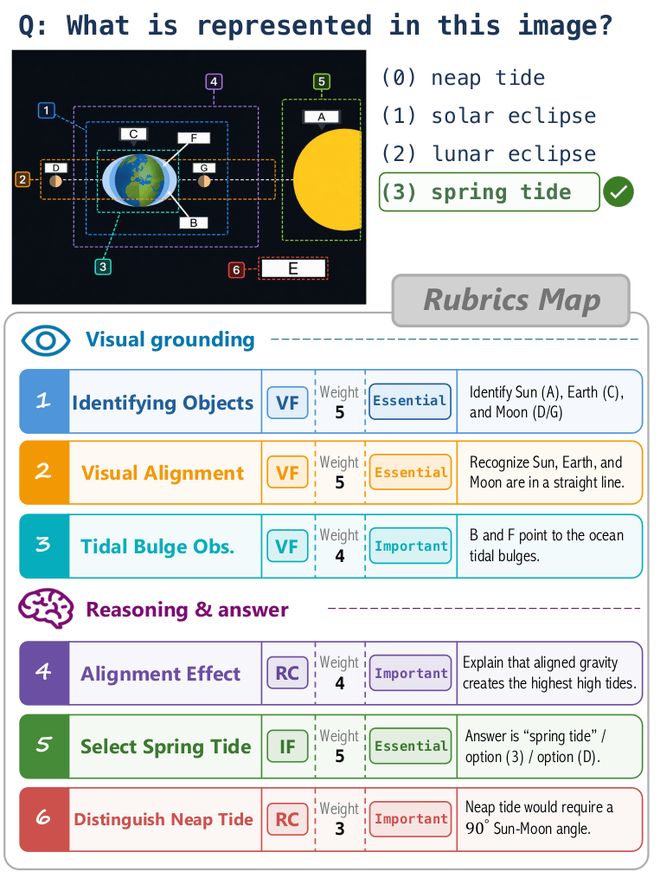
同一个视觉问题被拆成 VF、RC、IF 三类原子准则,每条准则均可独立判断并带有权重。
的设计也很重要:每条 都只检查一个原子项,同时要求表述尽量简短,单独拿出来也能看懂,并配有重要性标签和相应权重。、、 分别对应必须答到、重要但非必需,以及可作为补充的内容; 则专门标出常见的幻觉和推理错误。这样一来,模型答对了什么、又在哪一步出了错,都可以分别计分。
怎样让自动评分有据可查?
以几何题为例,“回答应当正确”并没有给评分器提供多少额外信息;如果分别写明应读取的边长、适用的公式和目标面积,检查对象就明确了。论文要求 指向具体可见的事实,并在单条准则中写清对象和成立条件,同时覆盖关键观察与中间推理。
这些检查项也有重要程度之分。视觉问答采用 VF ≫ RC > IF 的优先级,将视觉事实放在首位,再考虑推理与指令约束;、、 的正向权重为 1 到 5, 则标记为 -1 或 -2。
生成准则时,模型读取原图、指令和参考回答,将需要核查的事实写入 ;训练时, 只读取生成回复与这些自包含准则(self- ),不直接读取原图。
5 万道题
如何提供 35 万条具体反馈?
V- 50K 从 17 个公开视觉数据源中选取样本,涵盖图表与文档问答、示意图、视觉数学、计数、教育问答和通用视觉推理,并按有效性、内容质量与重复性进行了初步筛选。
为判断题目是否还有训练价值,团队让监督微调(SFT)后的模型对每个候选样本回答 8 次:全部答对的题目会被剔除,因为最终答案奖励已难以在这些回答之间提供区分;其余样本则根据答对比例划分难度。这里衡量的是模型的实际表现,难度标签用于组织固定的训练数据组合。
最终保留的 50,248 个样本中,hard 级别的问题占 36.1%, 占 50.4%, 占 13.6%。
随后,-3-Pro 按照统一的图像条件化协议(image- )生成 VF、RC、IF 准则,共得到 352,938 条 。其中,VF 为 209,436 条(59.3%),RC 为 101,369 条(28.7%),IF 为 42,133 条(11.9%)。接近六成准则用于检查视觉事实,使“是否准确理解图像”成为最主要的监督内容。
每个样本都包含图像、题目、参考回答和对应准则,训练时可以分别检查各项要求的满足情况。
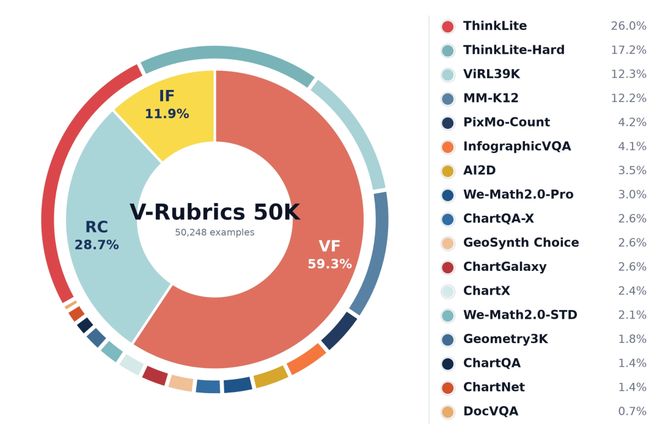
V- 50K 的数据来源与 VF、RC、IF 准则分布
评分拆开之后
怎样进入强化学习?
逐项打分还只是第一步。如果立即把所有准则合成一个总分,再用这个分数更新整段回复,各项判断之间的区别仍会在信用分配时被压缩。为了解决这个 的坍缩问题,V- 因而同时调整了奖励内容与信用分配方式。
在主实验中,答案正确性和 满足度各以 0.5 的权重计入语义奖励,同时保留标准格式奖励。答案奖励检查任务是否完成, 奖励检查回答是否满足各条准则,后者逐项给出“满足”或“不满足”的判断。
对于同一道题,系统分别比较多条生成回复的最终答案和各条 得分。例如,一组回答可能都没有得到正确结论,但只有部分回答准确读出了图表数值;逐项比较就能保留这项差异。反之,若所有可评分回答在某条准则上得分相同,这一项便不产生组相对梯度。
让训练信号与证据所在的回复前缀对应
在构造训练优势()时,答案得分与各条正向 得分分别在同一组 中标准化。最终答案的信号覆盖整段回复,而每条 保留独立的优势信号,按照对应权重参与更新。
接下来, 会为每项判断返回对应的原文证据句,系统再通过模糊匹配,在生成回复中定位这些句子。每项 的 仅作用于从回复开头到对应证据句末尾的前缀,后续内容不再使用这一 。若无法可靠定位证据句,则仍按 逐项计算 ,但将其作用范围回退到整条 。
对于已确认触发的幻觉或推理陷阱, 会启动语义奖励的否决机制,取消相应回复的答案信用与正向 信用。正向检查项用于提供部分得分,负面检查项则用于约束已知错误。
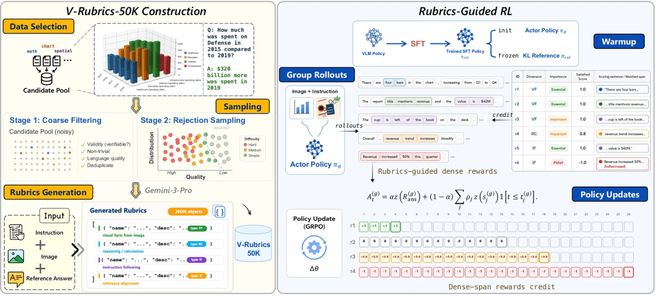
V- 的数据构建与强化学习流程
震撼,Opus 5.5首次颠覆Dijkstra算法最短路径!
Vals AI通过10个Claude Opus 5.5 Ag...(126 )人阅读时间:2026-09-28
答案正确,推理就可靠吗?V-Rubrics用35万条细粒度准
V-Rubrics通过将视觉样本拆分为可逐项检查的准则,分别...(93 )人阅读时间:2026-09-28
刚刚,Gemini 4 Pro全新曝光,实测碾压Opus 5
谷歌Gemini 4 Pro曝出全新检查点「barium-b...(181 )人阅读时间:2026-09-28
GPT-6自己打开软件干活了!一张图纸长出3295个零件,一
OpenAI的Astra模型展示了惊人的3D建模能力,能根据...(150 )人阅读时间:2026-09-28 在科技巨头纷纷因AI资本开支扩大而受质疑时,苹果因AI进展缓...
 算力正走向消费市场。信通院发起“算力超银生态共建计划”,联合...
 OPPO推出FatMax超燃脂模式,通过个人数据建立个性化燃...
 Claude code团队分享了在快速迭代中优化产品的心得,...