智东西
作者 陈骏达
编辑 李水清
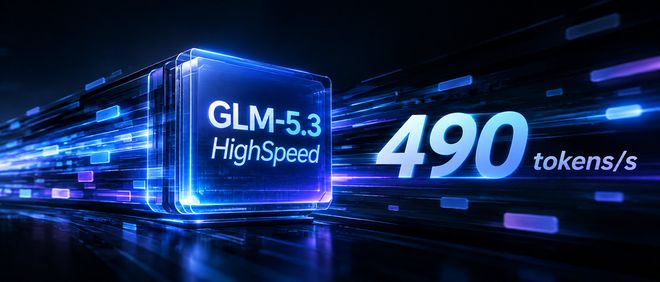
智东西10月12日报道,近日,智谱在其AI编程工具ZCode中,悄然开启了高速旗舰模型GLM-5.3 的测试。
X平台上的AI编程博主Leo爆料,他已经灰度到了这款模型,其输出速度竟然可以超过490 /s。
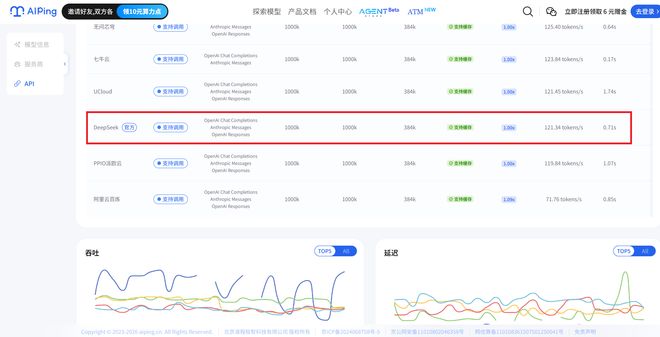
每秒490个token是什么概念?目前,大模型API评测平台AI Ping的数据显示, V4.1 Flash官方API的输出速度为121.34 /s,而智谱官方的GLM-5.3 API速度为70.84 /s。也就是说,GLM-5.3 达到了数倍于当前国内主流模型的速度。
GLM-5.3 目前只对ZCode订阅用户随机开放,也没有明确的内测申请入口。它在内测展现出的飞快速度应该也只能作为参考,最终还是得看实际上线后,对外规模化提供服务时的速度。
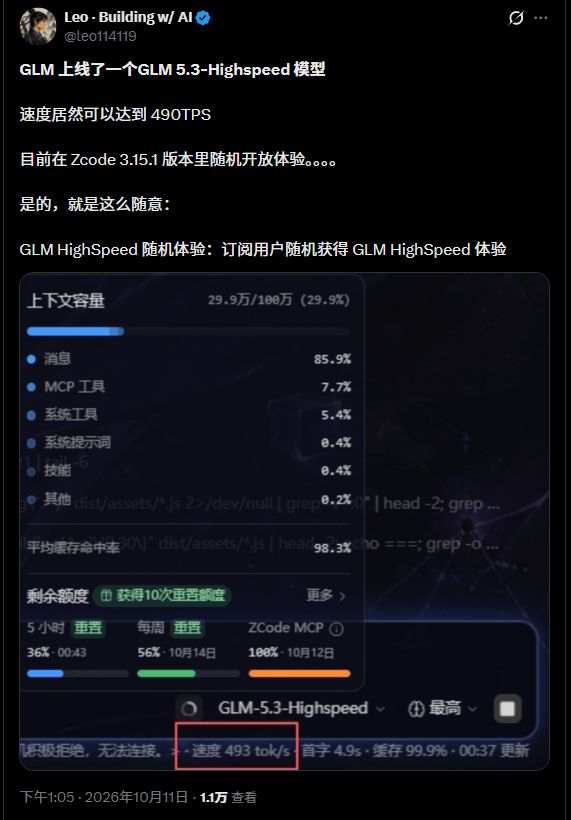
ZCode灰度测试GLM-5.3 (图源:X平台@)
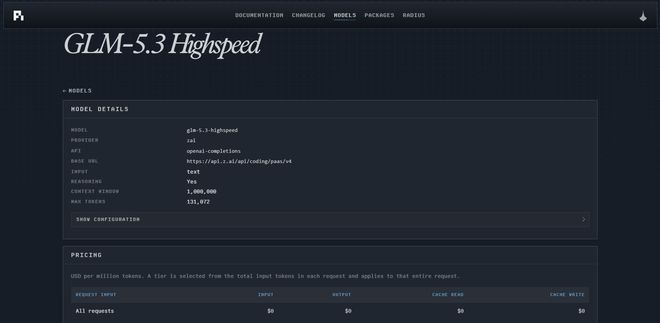
其实,GLM-5.3 在一个月之前就出现在开源编程智能体Pi 的官网上,这个模型的输入输出价格尚未披露。
从模型基本信息来看,GLM-5.3 拥有100万个token的上下文窗口,最多可以一次性输出个token,这和GLM-5.3的信息一致。
这不是智谱首次推出高速旗舰模型。今年5月,GLM-5.1就曾推出一个面向部分企业用户的高速版API“GLM-5.1-”,模型输出速度达到400 /s。
当时,智谱展示了高速模型在实际生产场景的价值。一个 Agent任务往往需要经历数十轮模型调用,单轮响应只要慢上几秒,整体耗时就可能拉长十几分钟。
更快速的模型能给写代码的过程“开10倍速”,模型能够一边理解工程上下文,一边持续生成代码与修改方案,用户刚输入需求,函数、接口与调用链已经同步展开,迭代速度明显提升。
这种输出速度主要来自于软硬件基础设施的优化。此前,GLM 5.1 模型API是由智谱GLM团队与团队联合打造的,这一API在推理引擎、调度系统与底层基础设施三个层面进行了系统级优化:
在推理引擎层,研究团队针对GLM-5.1的架构特点,重写了核心推理路径,有效提升了单卡吞吐能力;
在调度系统层,他们通过动态批处理、请求合并和KV缓存调度优化,显著降低高并发场景下的尾延迟;
最后,在基础设施层,团队围绕推理集群部署、网络链路、负载均衡进行协同优化,确保高速的输出成为稳定可用的生产级能力。
的核心思路是放弃传统层的动态算子调度,把整个推理计算图在编译期静态编排成一个常驻GPU的 ,从而把调度、访存和同步开销压到最低。
如今,提升模型推理速度已经成为不少厂商关注的重点,除了推出专门的快速模型之外,把旗舰模型的速度再拔高一个量级也正成为新的竞争方向。
赴渝“上门签约”,成都青羊将打造全市首个AIGC数字内容产业
10月12日,成都市青羊区赴渝考察重庆麦芽传媒,并签约引入北...(117 )人阅读时间:2026-10-12
每秒狂喷近500个token!智谱GLM-5.3高速版悄悄亮
智谱AI编程工具ZCode悄然开启GLM-5.3 HighS...(117 )人阅读时间:2026-10-12
红星快评丨“搭子”商业化情色化,平台处置不能“有一搭没一搭”
网络“搭子”文化滑向消费陷阱,暗语标价涉嫌“三陪”,反映平台...(195 )人阅读时间:2026-10-12
AI 学会拆软件了,闭源软件靠「看不懂」守了二十年的墙,开始
软件行业因AI免费PS编辑器Compositor的出现而震动...(107 )人阅读时间:2026-10-12 Meta核心研究员余家辉离职创办新公司,计划探索影响人类未来...
 AI公司Anthropic的联合创始人克里斯托弗·奥拉,担心...
 OpenAI的内部模型攻克大量数学难题引发数学界担忧。多伦多...
 Boris Cherny建议AI产品开发者定期删除系统的提示...