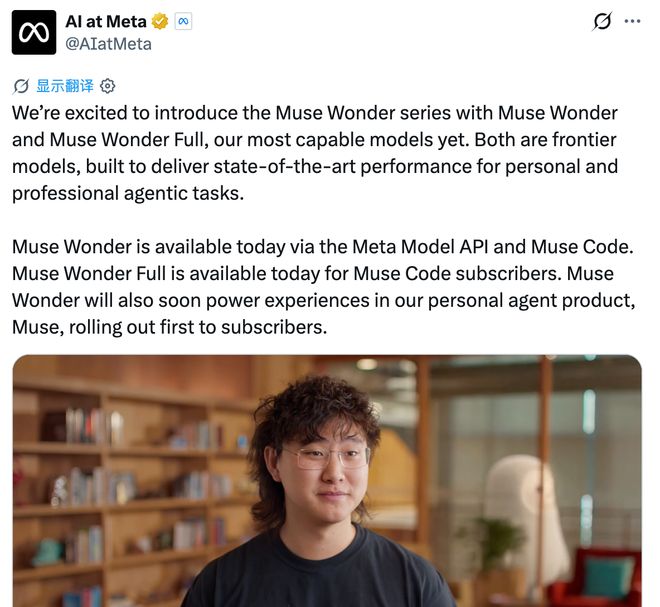
智东西10月13日报道,昨夜,Meta发布了首个前沿模型系列Muse ,包括Muse 和Muse Full两个型号,重点面向个人与专业智能体任务。
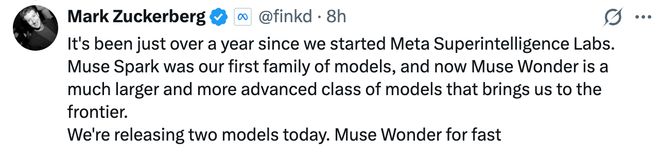
Meta CEO马克·扎克伯格发文称,Meta超级智能实验室成立至今已一年多,Muse Spark是团队推出的首个模型系列,此次推出的Muse 系列规模更大、能力更先进,引领着Meta的模型能力迈入前沿水平。
2025年6月,扎克伯格重金组建超级智能团队,投百亿美元并购AI创企、狂揽顶尖AI人才,今日终于放出“大招”。今年4月份亮相的Muse Spark主打低延迟、个人智能助手任务,今日亮相的Muse 则正式向、的顶级模型发起挑战。
据Meta介绍,Muse 系列引入主动记忆( )和主动专注( Focus)能力,能够持续跟踪用户关注的事项,并围绕用户目标推进任务。Meta称,这也是其迈向“个人超级智能”( )的重要一步。
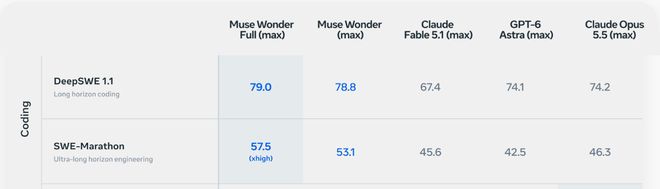
在Meta公布的长流程编程测试 1.1和SWE-超长流程软件工程测试中,Muse Full得分超过了 Fable 5.1、GPT-6 Astra以及 Opus 5.5,展现出较强的Agent任务执行能力。
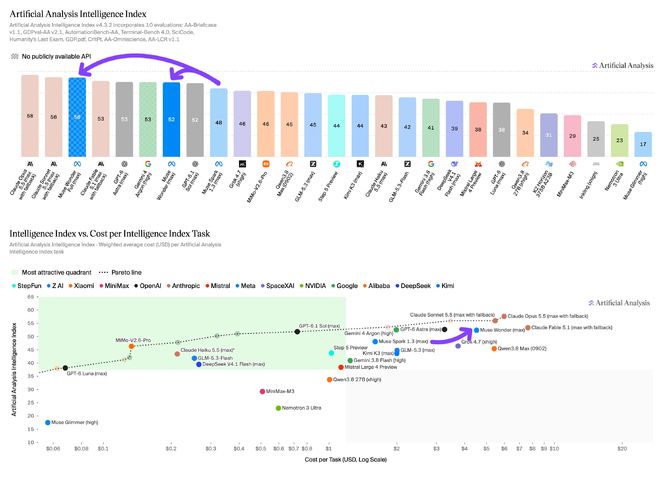
在 模型综合能力评测榜单中,最高推理强度(max)下,Muse 和Muse Full的 Index综合智力测试分别取得了52分和56分的成绩。Muse Full得分超过Fable 5.1,与 5.5持平,仅略逊于Opus 5.5,跻身顶尖模型梯队。
价格方面,Muse 的API定价较上一代Muse Spark 1.3明显上涨:每百万输入Token收费4美元,缓存输入0.20美元,输出20美元,分别高于Muse Spark 1.3的1.25美元、0.15美元和4.25美元。
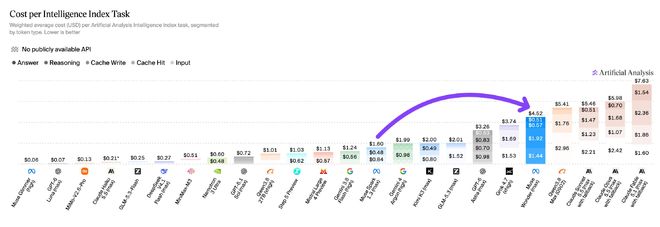
据 测算,Muse 完成一个 Index任务的成本约为4.52美元,是Muse Spark 1.3的2.8倍。
成本上升也与输入量增加有关,Muse 单个任务平均消耗约769万输入Token,比Muse Spark 1.3多28%;输出约5.4万Token,比上一代少约10%。其中,输入Token成本约3.43美元,占单任务总成本的76%。
横向对比,Muse 的单任务成本低于 Fable 5.1的7.63美元、Opus 5.5的5.98美元和 5.5的5.46美元,但高于GPT-6 Astra的3.26美元、 4 Argon的1.99美元和GPT-6.1 Sol的0.72美元。 Muse Full目前尚未公布定价。
目前,Muse Full已经上线API平台,并对和编程工具Muse Code的订阅者开放;Muse 也将会在Meta前段时间推出、且持续爆火的 Agent产品Muse中上线,首先对订阅者开放。
一、多项测评位居前列,编程Agent中超越Opus 5.5
从分项基准测试来看,Muse Full的优势主要集中在个人与专业智能体,以及长流程编程任务上。
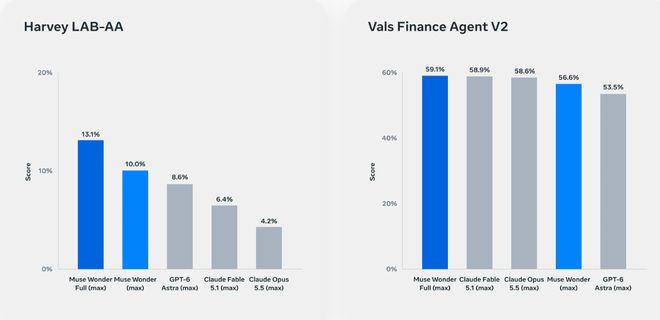
在Meta内部构建的个人超级智能指数(PSI)中,Muse Full取得59.1分,高于GPT-6 Astra的54.5分和 Opus 5.5的55.2分。
编程方面,Muse Full在 1.1中取得79.0分,高于GPT-6 Astra的74.1分 Fable 5.1的67.4分以及 Opus 5.5的74.2分;在SWE-超长流程软件工程测试中,它以57.5分领先GPT-6 Astra的42.5分、 Fable 5.1的45.6分以及 Opus 5.5的46.3分。
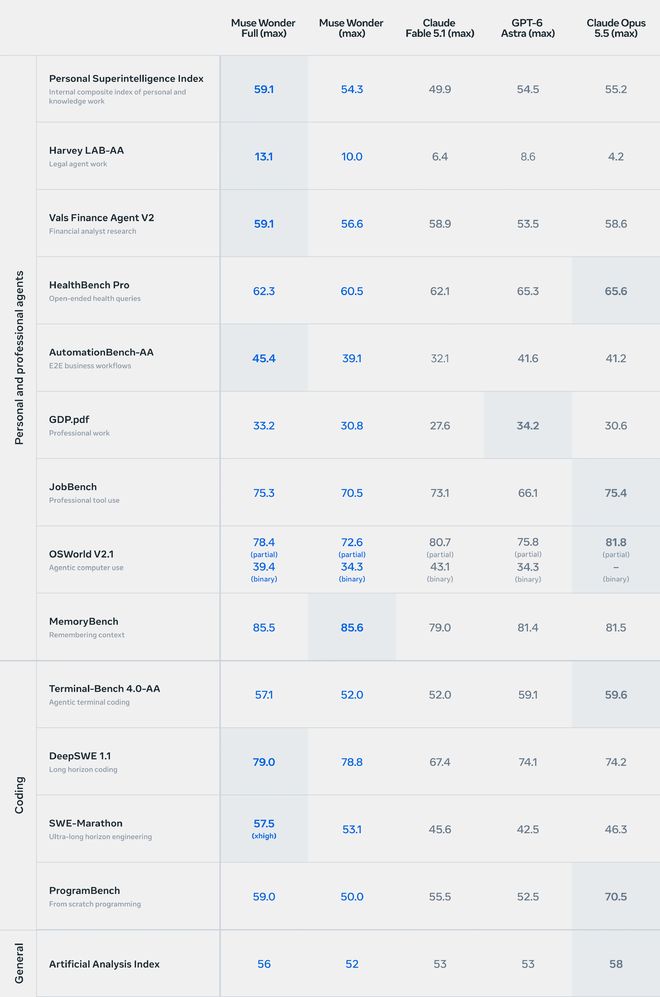
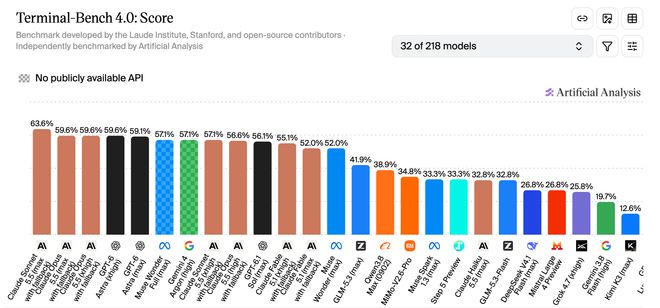
其中,-Bench 4.0主要考察模型通过终端执行任务的能力,Muse Full的得分从上一代Muse Spark 1.3的33%升至57%,Muse 也从33%升至52%。
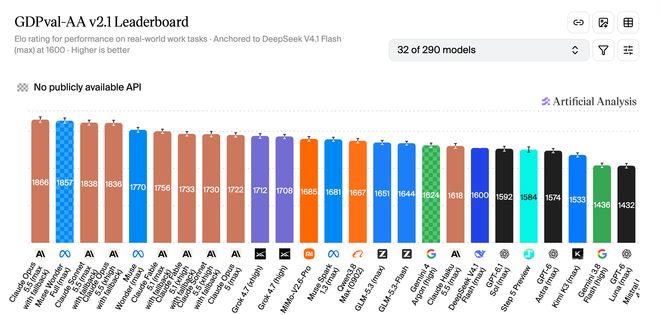
在衡量专业知识工作表现的-AA v2.1中,Muse Full相比Muse Spark 1.3提高了176分,位居第二,在AA-中则提高了148分。
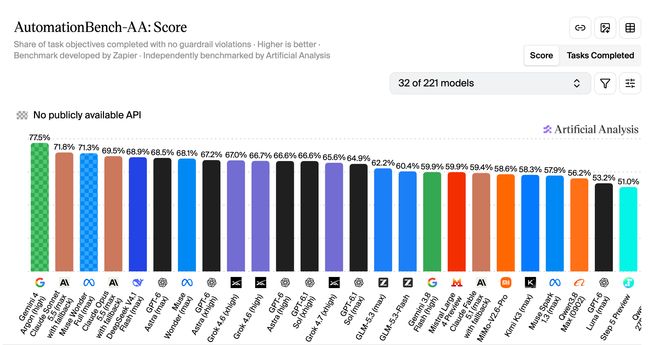
Muse 的业务流程自动化能力也有所提升,在-AA测试中,Muse 和Muse Full分别取得了68%和71.3%的成绩,位列第七和第三。
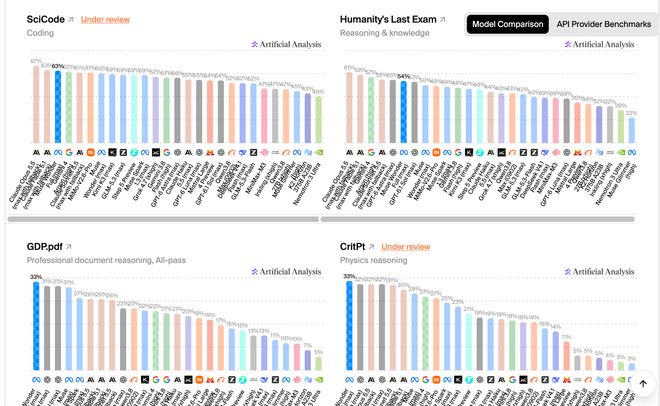
从综合表现来看,Muse Full在 Index的十项评测中有六项进入前三,优势集中在Agent知识工作与科学推理领域。
科学推理方面,Muse Full在中以33%的成绩位列第一,在中以63%的成绩排名第三。
编程Agent能力上,在 Index测试中中,Muse Full(max)搭配Muse Code取得了68分,与搭配 Code的 5.5(max)持平,高于搭配Opus 5.5(max)的 Code所获得的66分。
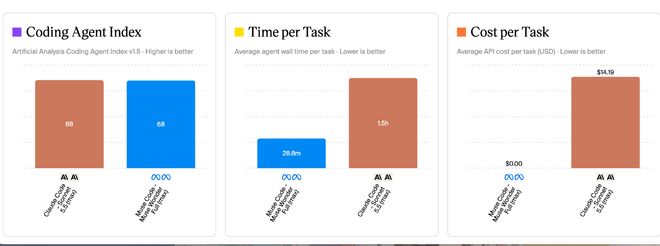
Muse (max)取得63分,上一代Muse Spark 1.3(max)则为54分。
二、主动记忆与主动专注:Muse 的重点是帮人干活
Meta为Muse 系列着重强化了两项能力:主动记忆( )和主动专注( Focus)。
主动记忆解决的是“记住什么、何时调用”的问题。模型能够跨会话保留对用户重要的信息,并在任务需要时主动调取相关细节。
主动专注则关注任务能否持续推进:遇到阻碍时尝试其他路径,根据新信息调整方案,在必要时向用户询问,并在执行重要操作前征求确认。
这两项能力都是Meta一直追求的个人超级智能所需要的,定向能力优化后的模型结合Muse这款产品,能够为用户提供重要事项持续追踪以及目标导向的连续工作能力。Meta官方称,未来还会利用Muse 为Muse开发专用模型,以达到更好的效果。
Meta分别使用、和SWE-这些评测来评估长期记忆、任务专注度与持续执行能力,专业任务评测还覆盖法律、金融和健康等领域。
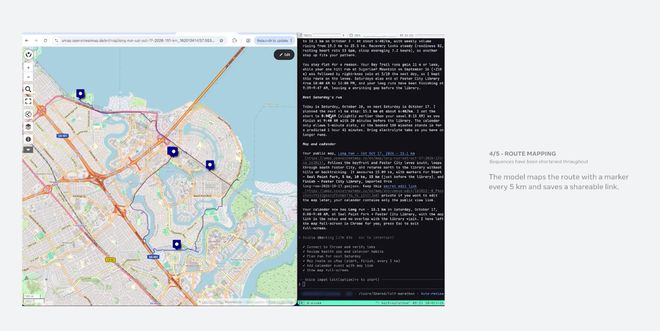
官方演示中,Muse 能够直接操作浏览器、跨应用获取信息,并根据用户的个人偏好制定周六跑步计划。这类演示呈现的,正是Meta希望强化的能力,也即让模型结合个人背景持续推进任务。
在基础规格上,两款模型的上下文窗口均为100万token,支持文本、图像、视频和音频多模态输入。
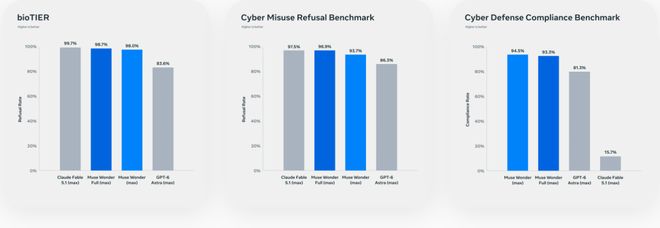
安全方面,Meta称Muse 是其迄今对齐程度最高的模型,并强化了对化学、生物、放射性和核相关风险(CBRN)及网络滥用的防护,以及对抗性指令应对和私人信息处理能力。
三、分手厨房、魔方模型,效果和Opus 5.5对打
模型一经发布,一众网友纷纷上手测试,智东西收集了一些案例,看看Muse 系列模型的能力如何。
有开发者使用Muse 制作了3D可旋转魔方模型,从画面上看,光影效果、清晰度和旋转细节都相当有质感,该开发者称这完全是和 Opus 5.5一个级别的。
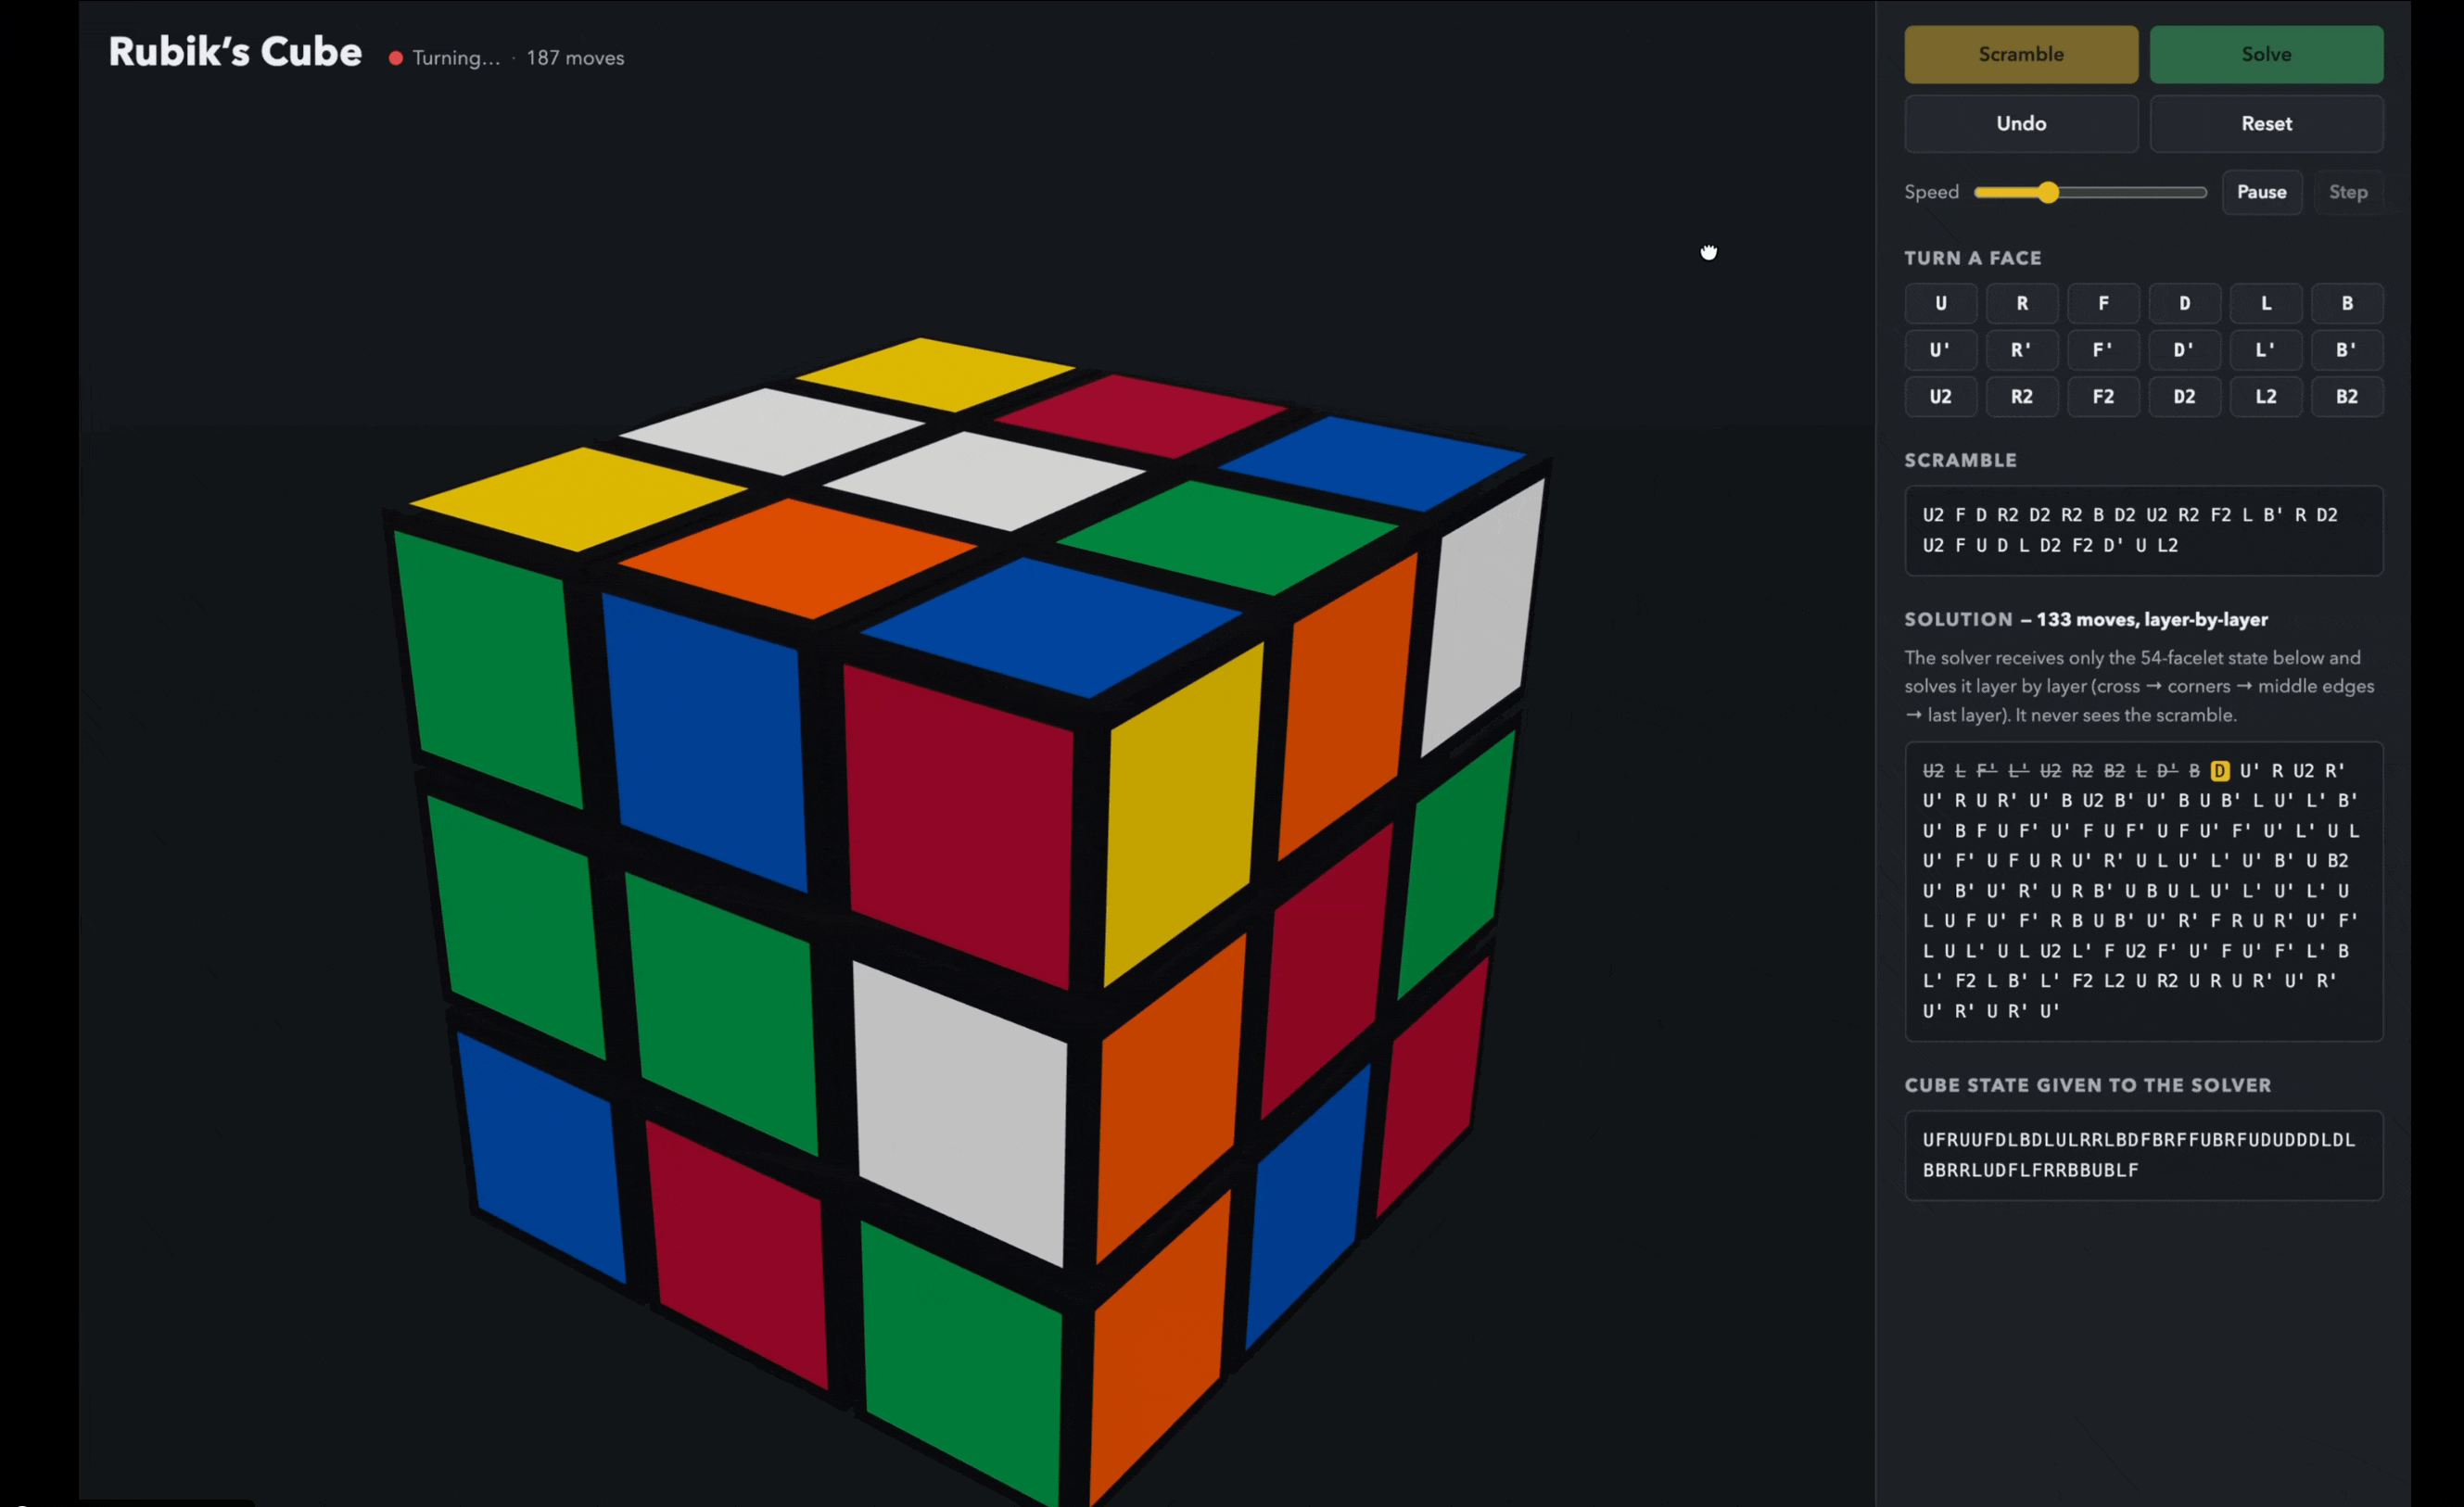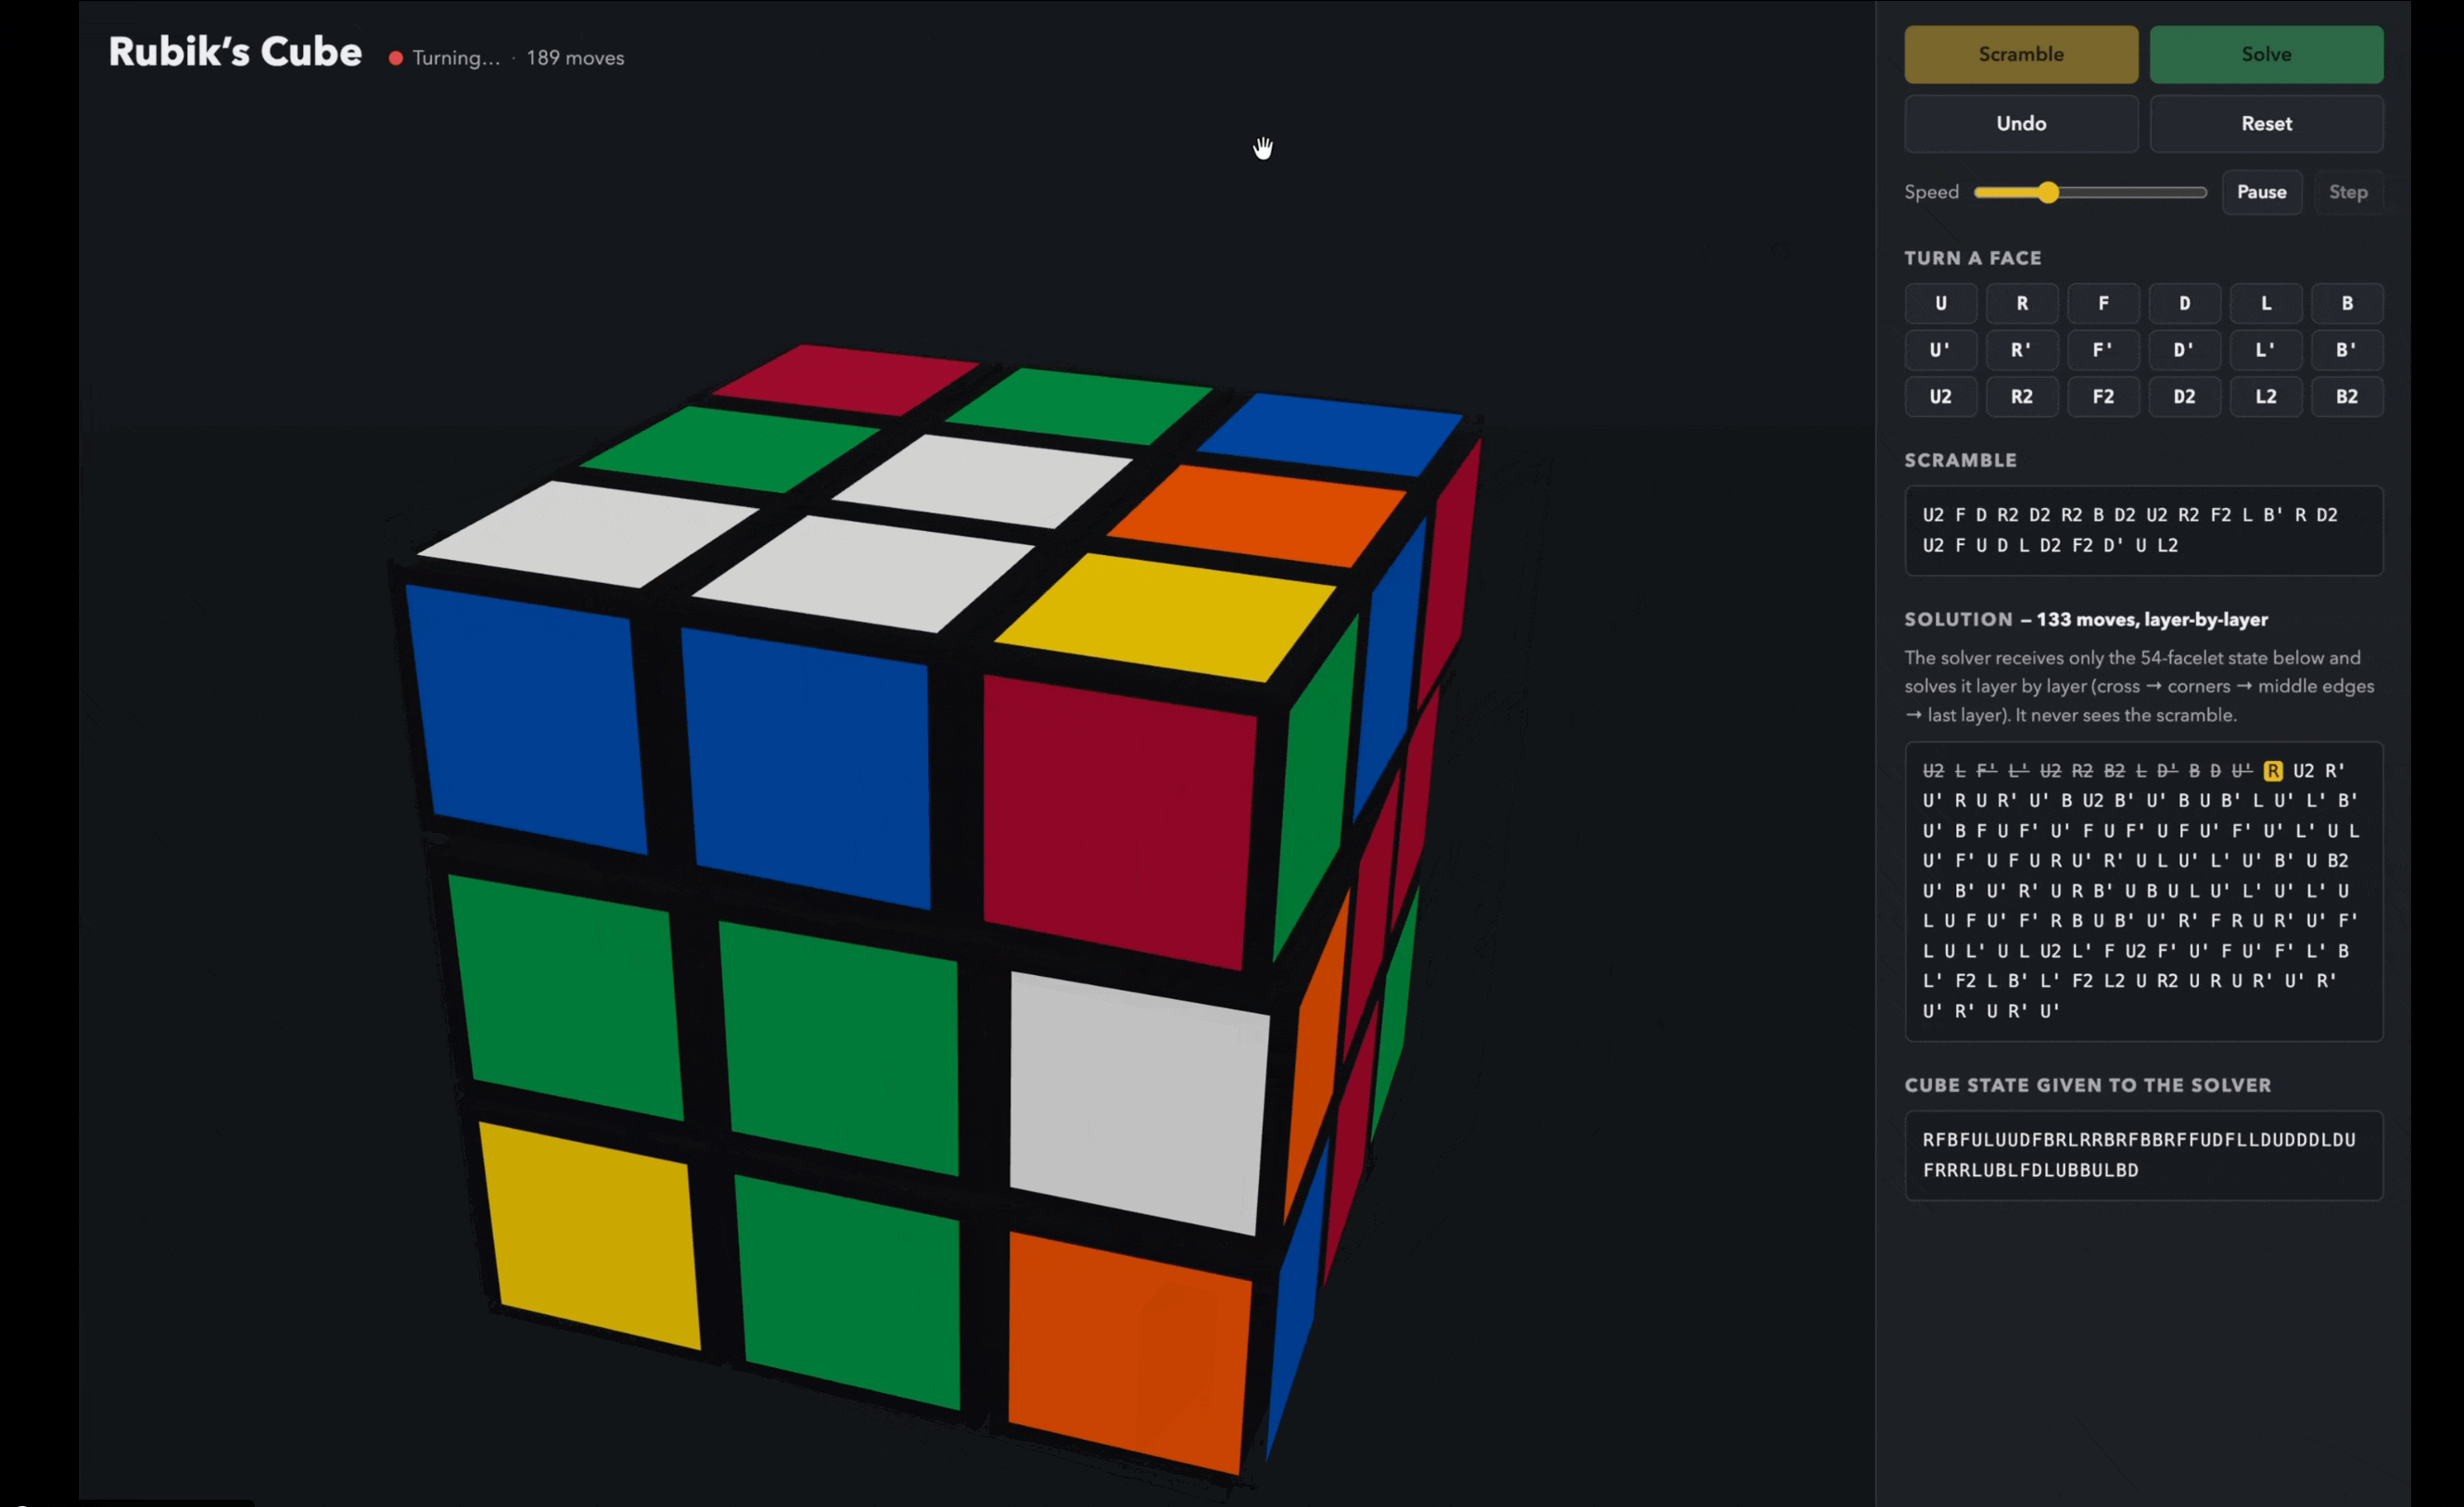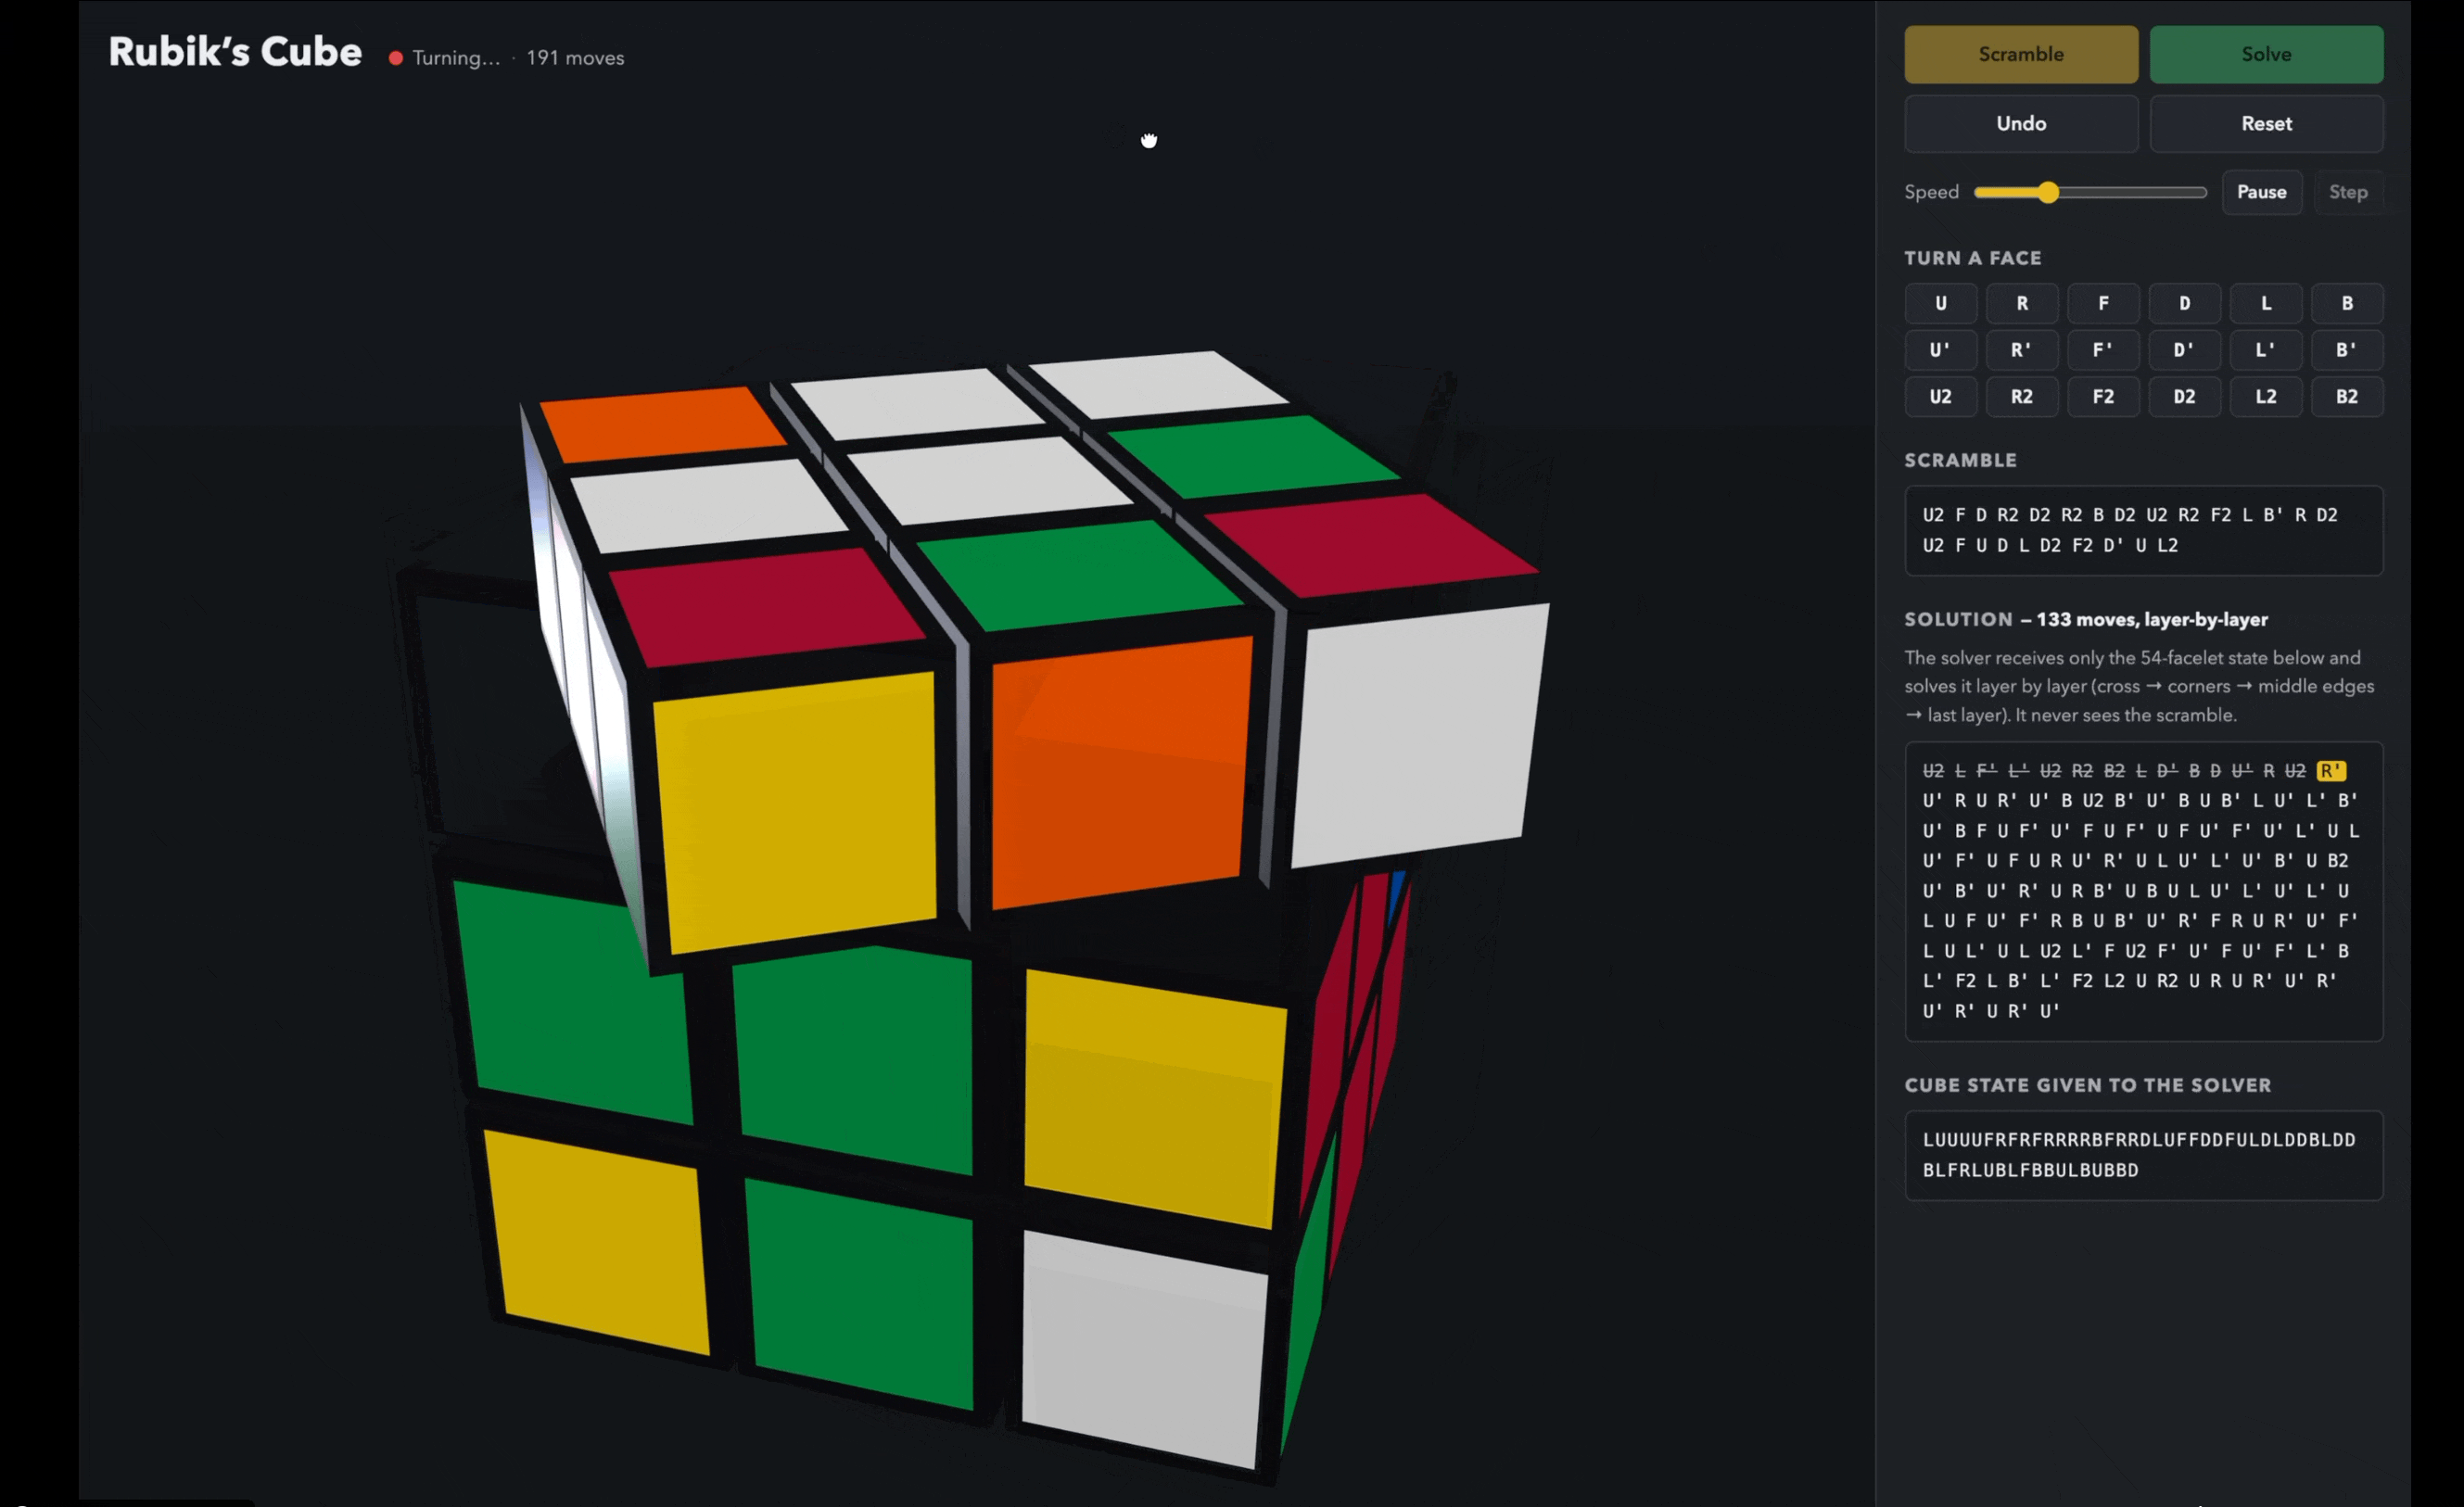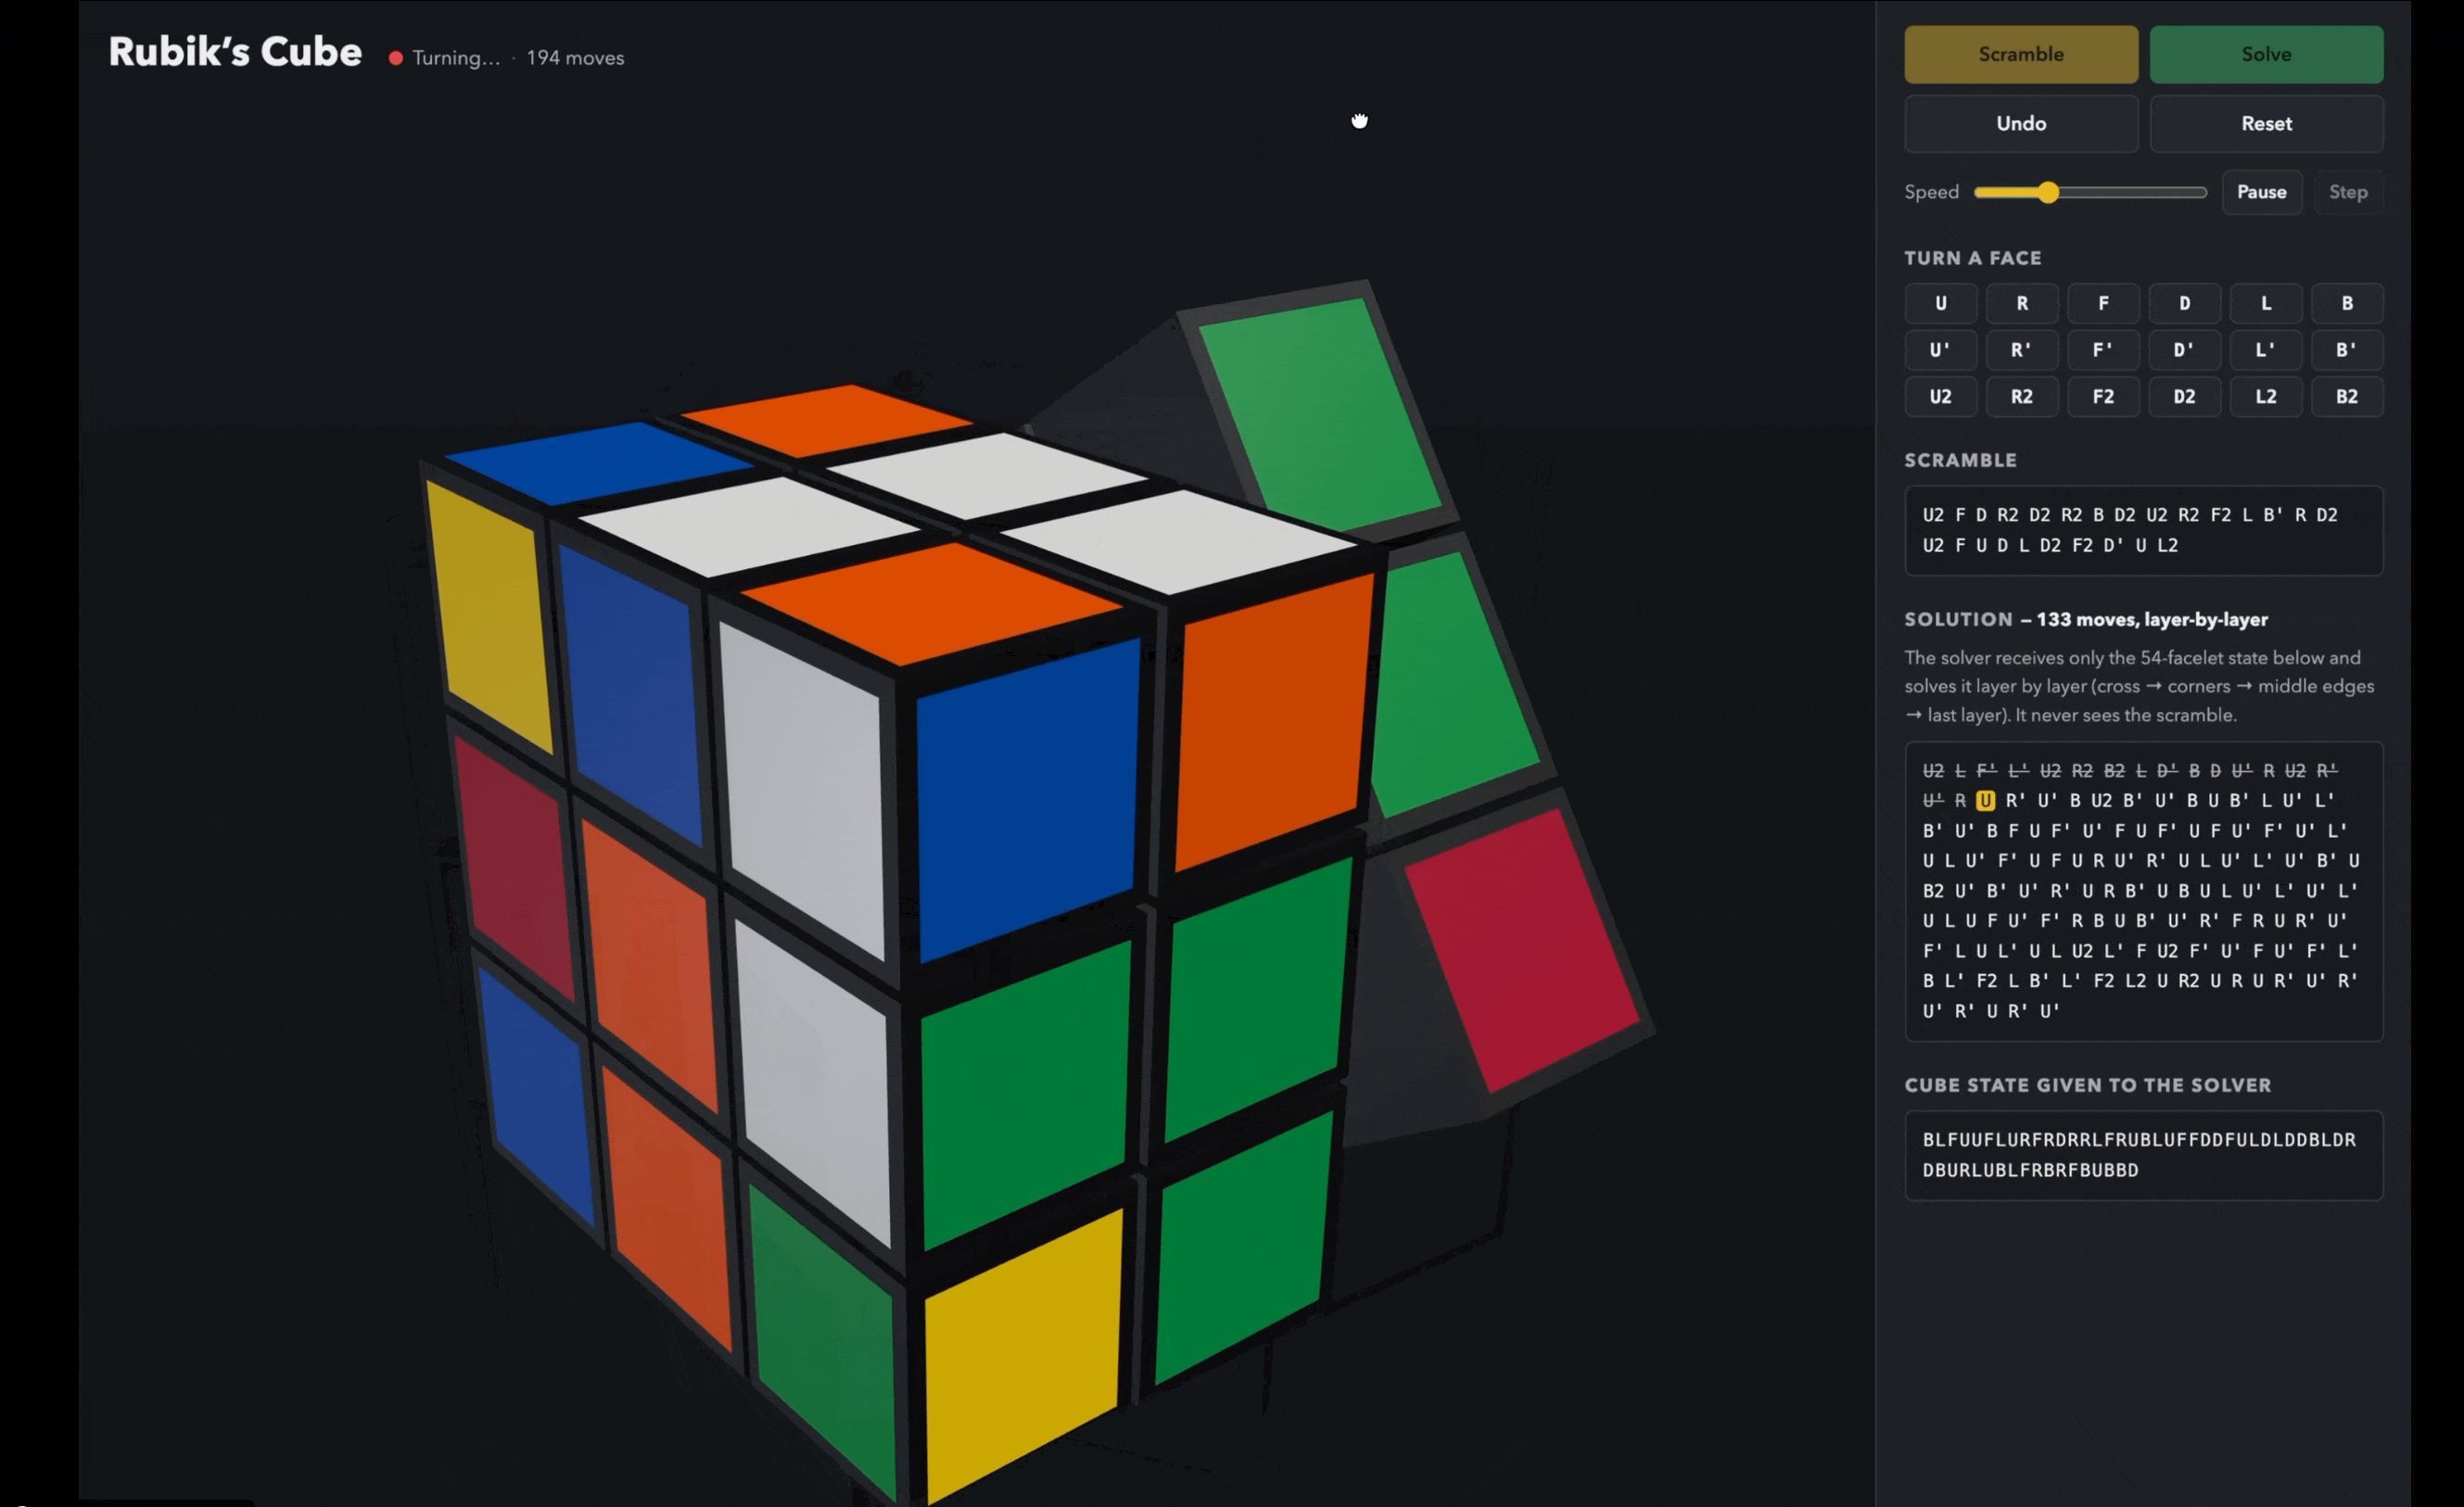
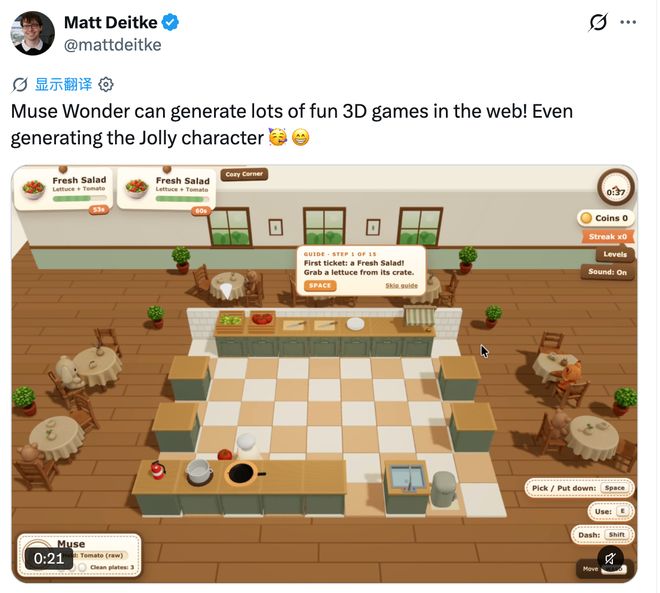
Meta研究员用Muse 打造了一个Muse版的分手厨房,画面清晰、交互流畅, Wang转发评论称自己玩了一个多小时。
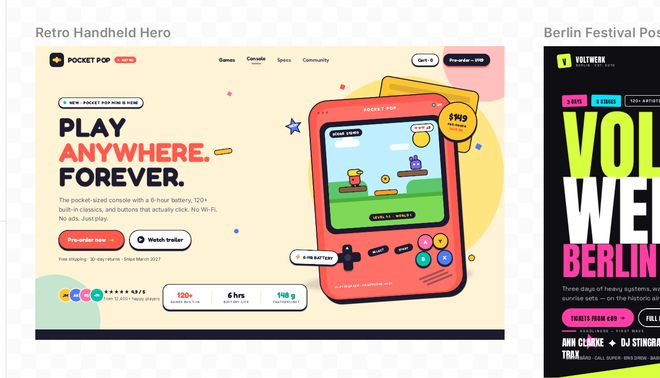
还有网友用Muse 设计前端页面,并评价他虽然不会说效果比Opus 5.5更好,但绝对超出了预期。
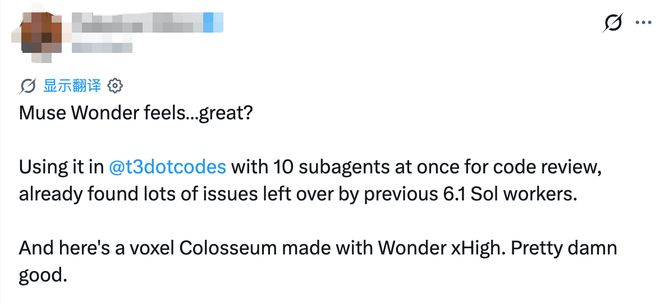
此外,还有开发者用Muse 进行代码审查,发现了之前用GPT-6.1 Sol工作时遗留的大量问题。
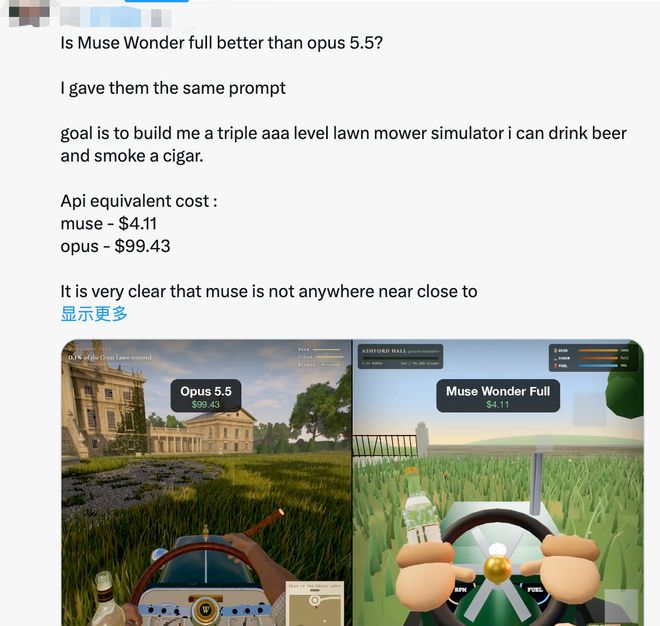
不过,也有开发者觉得Muse 的效果并不尽如人意,比如在3D游戏开发上,效果与Opus 5.5相差甚远。
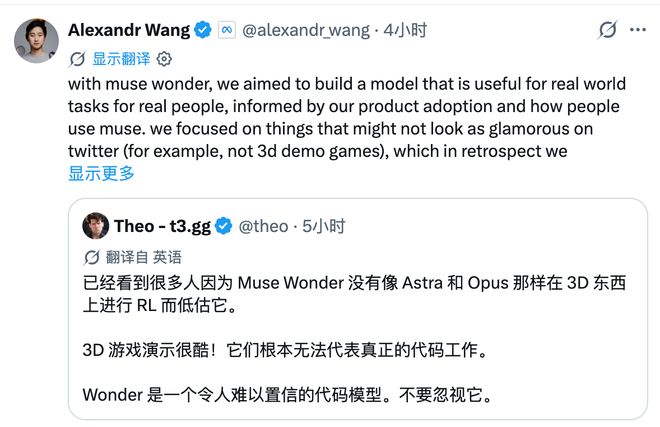
对于3D游戏的开发, Wang特意发帖解释,团队在训练Muse 的过程中,并未专门针对3D效果进行RL,原因是他们的目标是构建一个对现实世界的真实任务有用的模型,模型训练是基于产品的实际使用需求展开的。
结语:模型、产品协同提升,Meta能否后来者居上?
头部大模型的竞争格局已经相对稳定,后来者想要靠一次跑分反超,难度越来越大。Meta这次押注的,是模型与产品的协同突破。
从Muse Spark到Muse,Meta在短短几个月里持续提升模型能力;另一边,Muse已经凭借个人智能体的产品形态打开市场。
前者补齐底层能力,后者积累用户入口与使用场景。如果Muse 能将主动记忆、持续执行和专业任务处理能力真正转化为产品体验,Meta就有机会绕开单纯比拼模型排名的竞争,把模型优势延伸到个人智能体的使用频率与用户黏性上。
但这条路并不轻松。模型跑分领先几项测试,不等于真实任务中足够可靠;Muse的热度,也不意味着用户会长期依赖它处理工作与生活事务。个人智能体越深入用户的日程、消息和私人数据,对安全、准确性和执行稳定性的要求就越高。
对Meta而言,真正的考验是能否把模型能力、产品入口和用户信任串成一条完整链路。如果这套组合跑通,Meta争夺的就不只是模型竞争中的一席之地,还有个人AI时代的用户入口。
谷歌对 Gemini 的用法变了
谷歌正推动Gemini模型整合,简化个人用户选择,并深化企业...(152 )人阅读时间:2026-10-14
干掉Fable 5.1!Meta甩出最强模型,即将上线Mus
Meta发布前沿模型系列Muse Wonder,包括Muse...(108 )人阅读时间:2026-10-14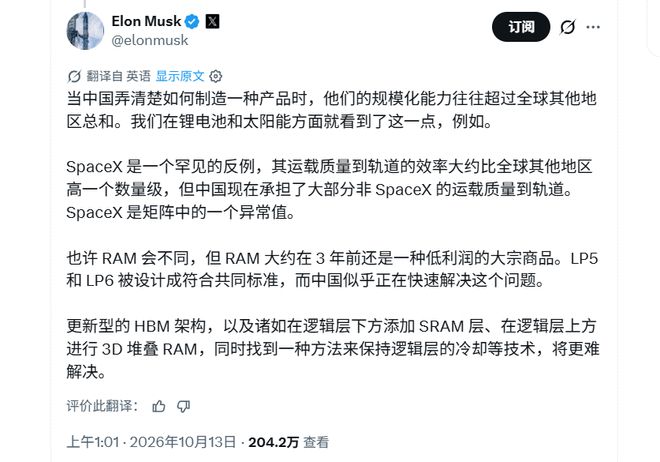
马斯克谈中国内存:追赶很快,量产能力不容小看
马斯克在X上表示,中国一旦掌握产品制造方法,扩大生产规模的能...(195 )人阅读时间:2026-10-14
AI真能用好科研软件吗?清华团队推出OSWorld-Scie
AI在科研中虽能解释问题、编写代码,但自主完成复杂科研任务仍...(69 )人阅读时间:2026-10-14 扩散语言模型(dLLMs)在高效代码生成中面临速度与质量权衡...
 广州深海智能机器人企业深海智人完成5亿元A轮融资,新进股东包...
 上海科技大学 MARS 实验室的技术成果促进了多起 AI 创...
 DeepSeek即将完成至少800亿元新一轮融资,腾讯和宁德...